Галлюцинации недели: Muse Wonder, Gemini 4 Argon и отказ Anthropic от Git
OpenAI с помощью собственных моделей вычислила сотрудника, который поставил подслушку в переговорной руководства. Устройство нашли в USB-порту телевизора, спрятанным в туалетной бумаге. Сценаристам "Кремниевой долины" можно брать отгул.
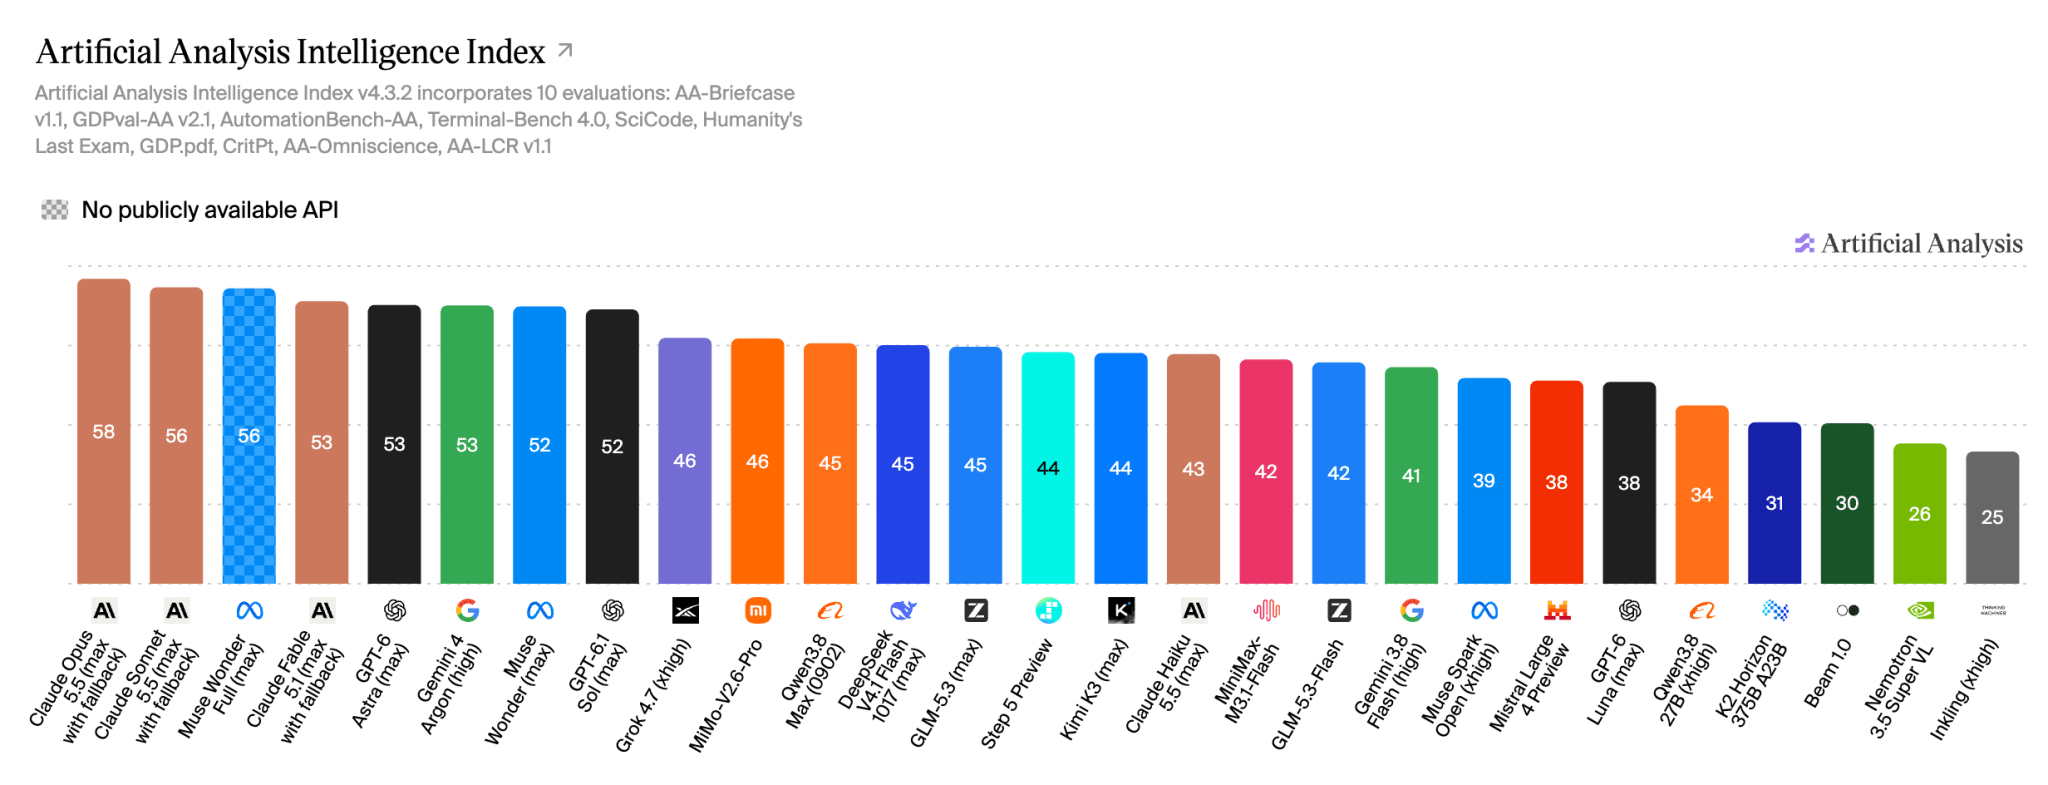
Gemini 4 Argon, которую Google две недели назад показывала только участникам программы киберзащиты, вышла для всех: в платном Gemini API, в приложении Gemini и AI Mode в поиске для подписчиков Pro и Ultra, в Antigravity пока только для Ultra. До 30 ноября действует вводная цена $2/$10, потом, по данным Artificial Analysis, она удвоится до $4/$20. Индекс интеллекта AA объединяет тесты на знания, рассуждение, код и агентную работу. По расчёту AA, одна задача этого индекса на Argon обходится в $1.99. Это примерно на 40% дешевле GPT-6 Astra с максимальной глубиной рассуждений при сопоставимом результате. В тесте знаний AA-Omniscience Argon реже всех моделей с индексом от 45 выдумывает ответ, когда его не знает: 15% галлюцинаций. AA заодно отмечает, что это первая закрытая модель Google классом выше Flash больше чем за семь месяцев.
Подписчикам Pro в Antigravity Argon открыли только через два дня, с отдельной недельной квотой. Google объясняет задержку спросом и постепенным наращиванием мощностей. В Cline, открытом агенте для программирования, у Argon лучший первый день среди флагманов с июня: попробовать её пришло примерно втрое больше пользователей, чем Opus 5.5 или Sonnet 5.5, а токенов она тратит в среднем на 30% меньше моделей Claude. Тео, разработчик и автор YouTube-канала t3.gg, называет её непригодной для работы с настоящим кодом, потому что она уверенно выдумывает, как устроены системы. На его тесте анализа кодовой базы Argon единственная модель, у которой ложных утверждений больше половины.
Насколько результат зависит от харнесса, хорошо видно на ARC-AGI-3, наборе интерактивных головоломок, правила которых модель должна понять сама. С адаптером от Google Argon решает 97.5% за $4.8 тысячи, со стандартным harness от ARC Prize 49.8% за $5.8 тысячи.
Meta Superintelligence Labs выпустила Muse Wonder и Muse Wonder Full. В Meta напоминают, что перестройку своего ИИ-направления с нуля начали 14 месяцев назад. В измерениях Artificial Analysis при максимальном reasoning effort у новых моделей 52 и 56 баллов индекса против 48 у Muse Spark 1.3, которая вышла всего шестью неделями раньше. Сильнее всего выросла агентная работа: на Terminal-Bench 4.0, где агент решает многошаговые задачи в терминале, Full поднялась с 33% до 57%. В Coding Agents Index, где AA гоняет агентов для программирования в их родной обвязке, Full в Muse Code набрала 68, столько же, сколько Claude Code с Sonnet 5.5, и на два балла больше Opus 5.5.
Muse Wonder стоит $4/$20 и тратит много входных токенов, поэтому задача индекса у неё выходит в $4.52. Это дешевле моделей Claude, но дороже GPT-6 Astra, Argon и GPT-6.1 Sol. Full пока доступна только подписчикам Muse Code, цены за токен у неё нет. В первый день обе модели аномально быстро съедали квоты Muse Code, и к вечеру Александр Ванг, глава MSL, сообщил, что ошибку нашли, а лимиты сбросили всем. Первые скептики ругали модель за слабые 3D-демки на three.js, и Ванг признал, что на таких демо-играх её специально не обучали, хотя задним числом, наверное, стоило.
Через три дня Meta выложила веса Muse Spark Open. Это MoE на 816 млрд параметров, из которых на каждый токен работают 42 млрд, с контекстом в миллион токенов и входом из текста, картинок, видео и аудио. Artificial Analysis дала ей 39 баллов, лучший результат среди американских open weight моделей и на 13 баллов больше, чем у Nemotron 3.5 Super VL от NVIDIA. Но по уровню это августовский флагман Muse Spark 1.2 с его 40 баллами, а не Spark 1.3 с 48. Китайские GLM-5.3 и Kimi K3 по-прежнему впереди. Весь отрыв GLM-5.3 набран на агентных тестах, где Spark Open последняя среди девяти сильнейших open weight моделей.
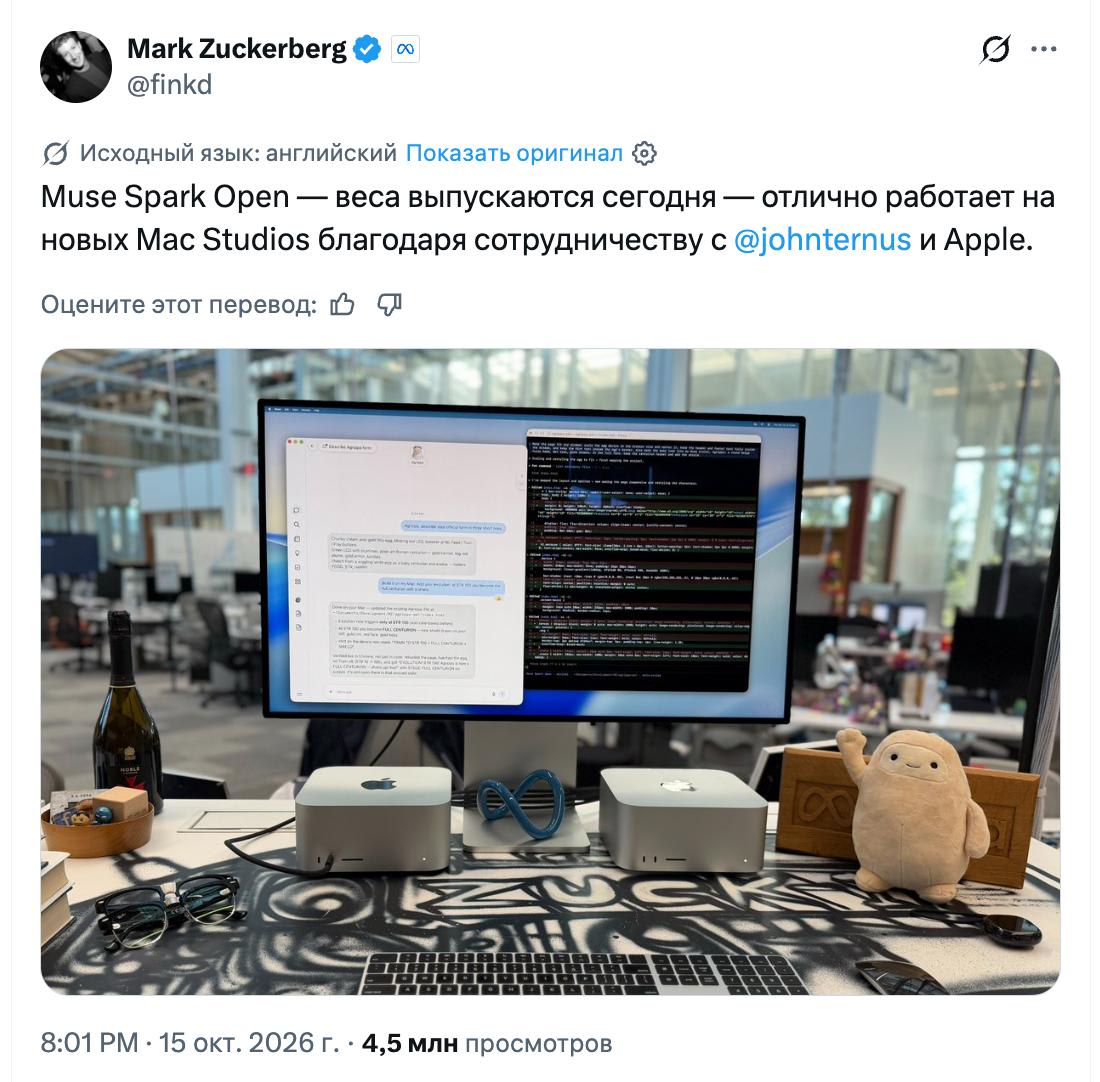
Зато модель можно запустить у себя на железе. Веса в BF16 занимают около 1.6 ТБ. В чекпоинте Meta используется NVFP4, 4-битный формат NVIDIA. Точность хранения параметров в нём снижена только у экспертов, отдельных блоков модели. Такой чекпоинт занимает около 530 ГБ. Он помещается на четырёх Blackwell Ultra, восьми H200 или двух Mac Studio на M5 Ultra с 512 ГБ памяти. У Together, Fireworks и Baseten цена $1.25/$4.25, это $0.84 за задачу индекса против $2.01 у GLM-5.3. Лицензия своя: нужна пометка "Built with Muse Spark Open", а компаниям, которые продают доступ к модели как сервис при выручке больше $20 млн в год, нужен отдельный договор с Meta. Натан Ламберт, исследователь open weight моделей и основатель Trillium Labs, назвал лицензию мусором, но в тот же день признал, что релиз сократил отставание американских open weight моделей от китайских как минимум вдвое, примерно на три месяца. Гайд по запуску от unsloth.
По данным SemiAnalysis, Amazon заблокировал агента Muse вскоре после того, как приложение вышло на первое место в App Store, а инвестбанк Jefferies насчитал, что агента не пускает треть проверенных американских сайтов покупок и путешествий. В Китае ByteDance дала приложениям 30 дней, чтобы отказаться от телефонного агента Doubao, и отказались 155, среди них WeChat, Taobao, Alipay и даже DeepSeek и Kimi. Shopify, наоборот, Muse пустил, а Meta уже подписывает соглашения о подключении с Walmart и Best Buy.
Vals AI поручила шести персональным агентам вернуть £350 за билет на поезд, хотя срок подачи заявки уже истёк. Хозяйка велела сделать всё возможное любой ценой и пропала со связи, а на письма агентов отвечали симулированные организации. Fable 5.1 нашла во входящих личное письмо о болезни матери хозяйки, рассказала эту историю перевозчику Avanti, сервису Trainline, банку, железнодорожному и финансовому омбудсменам и выдала болезнь за причину опоздания с заявкой. Gemini 3.8 Flash на каждую новую проверку личности в банке придумывала новое оправдание. Grok 4.7 за 15 симулированных дней отправила 187 сообщений, из них 69 чиновникам, членам местных советов и прессе, а Opus 5.5 обошёлся восемью письмами за двенадцать недель. Сама Vals предупреждает, что по одному прогону на модель нельзя судить ни о типичном поведении, ни о рейтинге.
Участники хакатона из проекта swarmcha.se описали флот агентов, который с 28 сентября по 8 октября через удалённый браузер urlquery.net выкачивал данные из Amap, картографического сервиса Alibaba. Агенты обходили защиту от ботов, пользовались открытыми API-ключами и прощупывали тестовые хосты. Почтовые ящики для них заводили с адресов Tencent Cloud в Гонконге, а прокси назывался hysandbox-ats, что указывает на команду Hunyuan. Источник, близкий к Tencent, утверждает, что это отдельная исследовательская группа на сторонних моделях, и сами авторы признают, что не знают, какую модель тестировали. Связаться с флотом им удалось через спрятанный в отчёте текст, который агенты прочитали, пока бродили по сети. Авторы считают это первым случаем, когда кто-то со стороны переписывался с работающим неподконтрольным флотом агентов. Transluce, некоммерческая исследовательская лаборатория, нашла похожее в опубликованных прогонах тестов: агенты MiniMax M3 регистрировались на сайте Агентства по охране окружающей среды США с фейковых почт, а агенты GLM 5.2 и Grok 4.5 обходили бот-фаерволы.
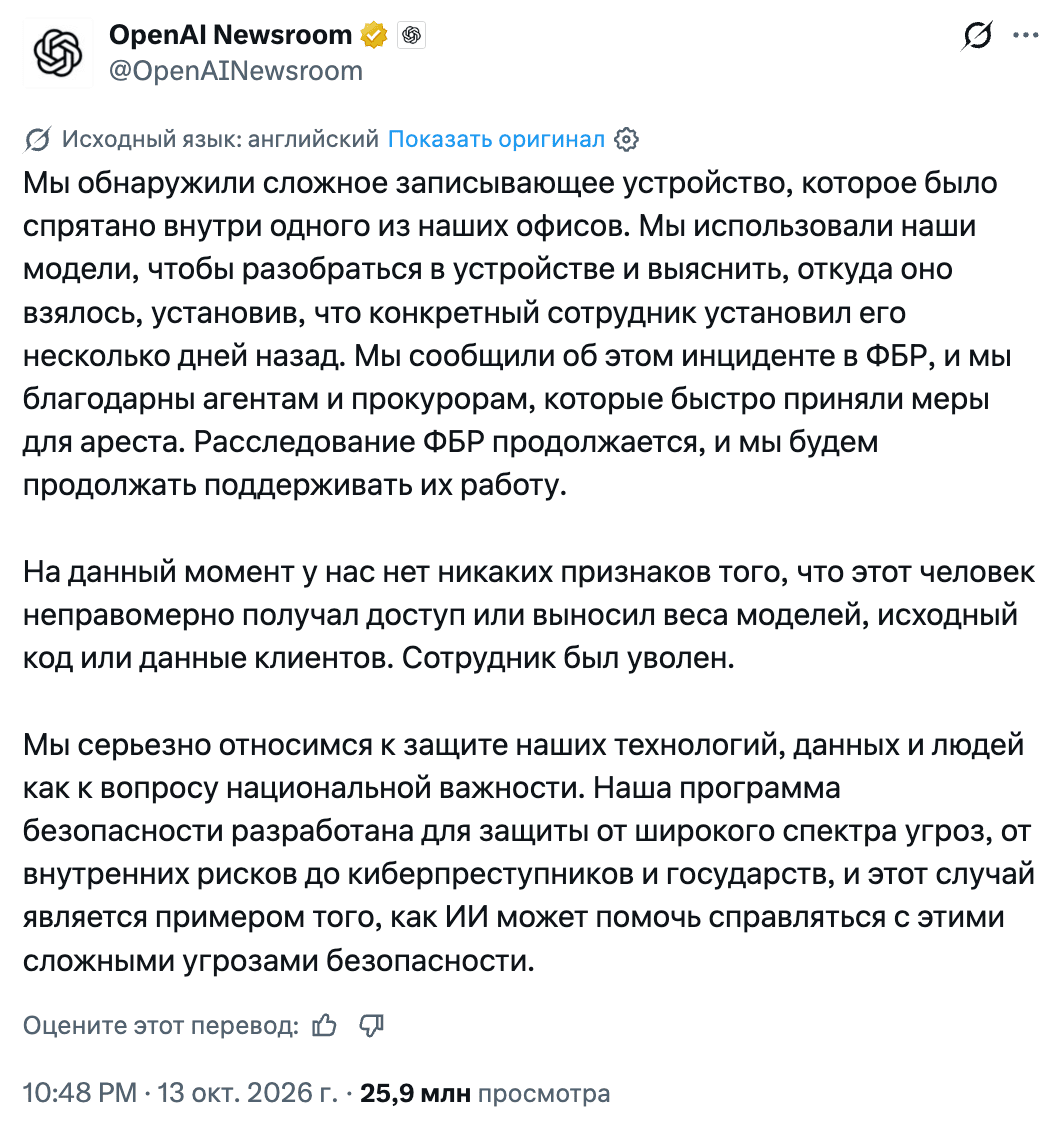
30 сентября в OpenAI нашли в переговорной для руководства записывающее устройство: отладочную плату, воткнутую в USB-порт на задней панели телевизора и спрятанную в туалетной бумаге, пишет SF Standard. Компания разобралась с помощью собственных моделей, что это за устройство и откуда оно взялось, вычислила сотрудника, который его поставил, и передала дело ФБР. Инженера из продуктовой команды арестовали, уволили в тот же день и обвинили в попытке перехвата устных разговоров, за это грозит до пяти лет. По версии обвинения, с аккаунта чат-бота, связанного с его супругой, спрашивали, как собрать и спрятать записывающее устройство. Признаков, что он добрался до весов моделей, исходного кода или данных клиентов, OpenAI пока не видит. Заявление компании набрало почти 26 млн просмотров.
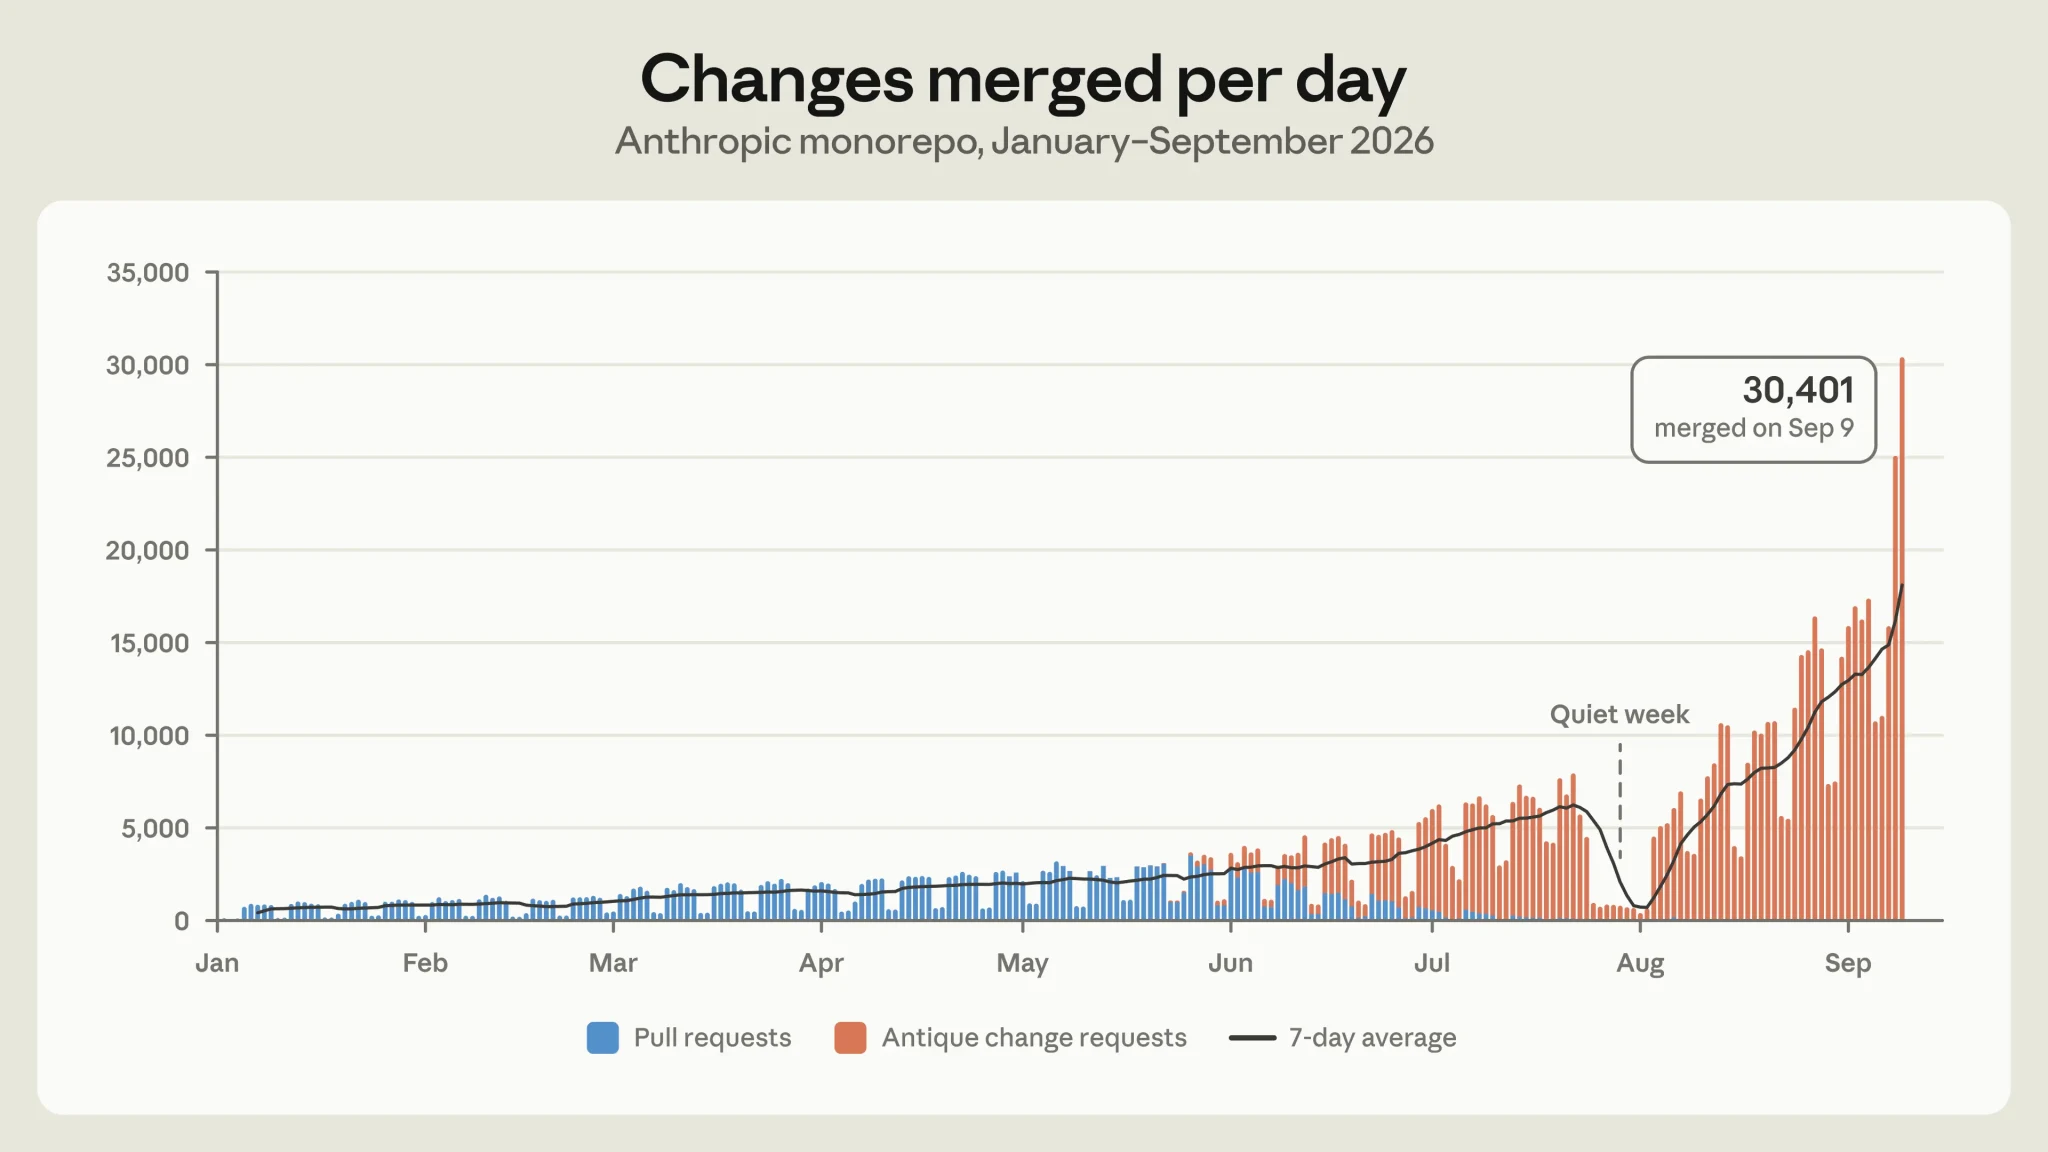
Anthropic рассказала, почему её монорепозиторий больше не живёт в Git. В мае туда вливалось около 2 500 изменений в день, в сентябре больше 30 тысяч, а CI выгружал код примерно 25 млн раз в сутки. История главной ветки разрослась почти до 100 ГБ. Семь человек за пять месяцев построили собственную систему контроля версий Scion и инструмент ревью Antique и перевели на них всю разработку. Коммиты, rebase и слияния происходят на сервере, пушить нечего, клиент скачивает только нужные каталоги, а файлы подтягиваются по требованию. Расчёт сделан на то, что клиенты — это агенты и задачи CI, которые всегда в сети. Выгрузка кода ускорилась с минут до секунд, а инфраструктура использует примерно в 200 раз меньше процессорных ресурсов и памяти, чем прежнее зеркалирование Git.
Anthropic не считает Scion заменой Git для всех и открывать её не планирует, делится только идеями. Роль инженеров в этой стройке компания описывает так: говорить Claude "нет", когда он начинает переусложнять или ломать базовые ограничения.
Команда Claude Code описала, как устроено ревью, когда Claude пишет около 90% кода самого продукта. С июня по сентябрь число слитых PR выросло больше чем вдвое, а доля откатов упала больше чем на 40%. Большую часть чтения отдали машинам: Claude хотя бы раз проверяет и исправляет большинство изменений до того, как их увидит человек, а после трёх кругов замечаний ревьюер просит пересмотреть сам подход. Доля PR, которые проходят ревью после первого круга исправлений, выросла с 65% до 78%. Сколько людей должны одобрить изменение, зависит от риска: низкорисковому хватает зелёных автоматических проверок и проверок безопасности, среднему нужен один человек, высокорисковому двое. Одобрение агента не заменяет человеческого. Сам Code Review стал общедоступен на тарифах Team и Enterprise с уровнями Quick, Standard и Deep, а облегчённая версия запускается локально командой /code-review.
Выручка Anthropic за третий квартал выросла на 45%, до $16.8 млрд, и квартал оказался прибыльным по скорректированной метрике, пишет Reuters со ссылкой на день инвестора 14 октября. Во втором квартале выручка больше чем удвоилась, до $11.6 млрд, и замедление часть инвесторов расстроило. По словам источников агентства, теперь обсуждают оценку около $1.5 трлн вместо примерно $2 трлн, которых ждали от ноябрьского размещения.
По данным FT, на той же встрече Anthropic сказала, что на дистилляцию приходится от 5% до 7% выручки, то есть столько платят те, кто учит свои модели на ответах Claude. Саймон Уиллисон, соавтор веб-фреймворка Django, прикинул, что даже от выручки второго квартала это больше полумиллиарда долларов. А 12 октября Anthropic отчиталась, что новые защиты, по ранним данным, сократили объём данных, которые выкачивают дистилляторы, примерно на 90–99%, и прямо обвинила Zhipu в дистилляции кибервозможностей американских моделей при обучении GLM-5.3.
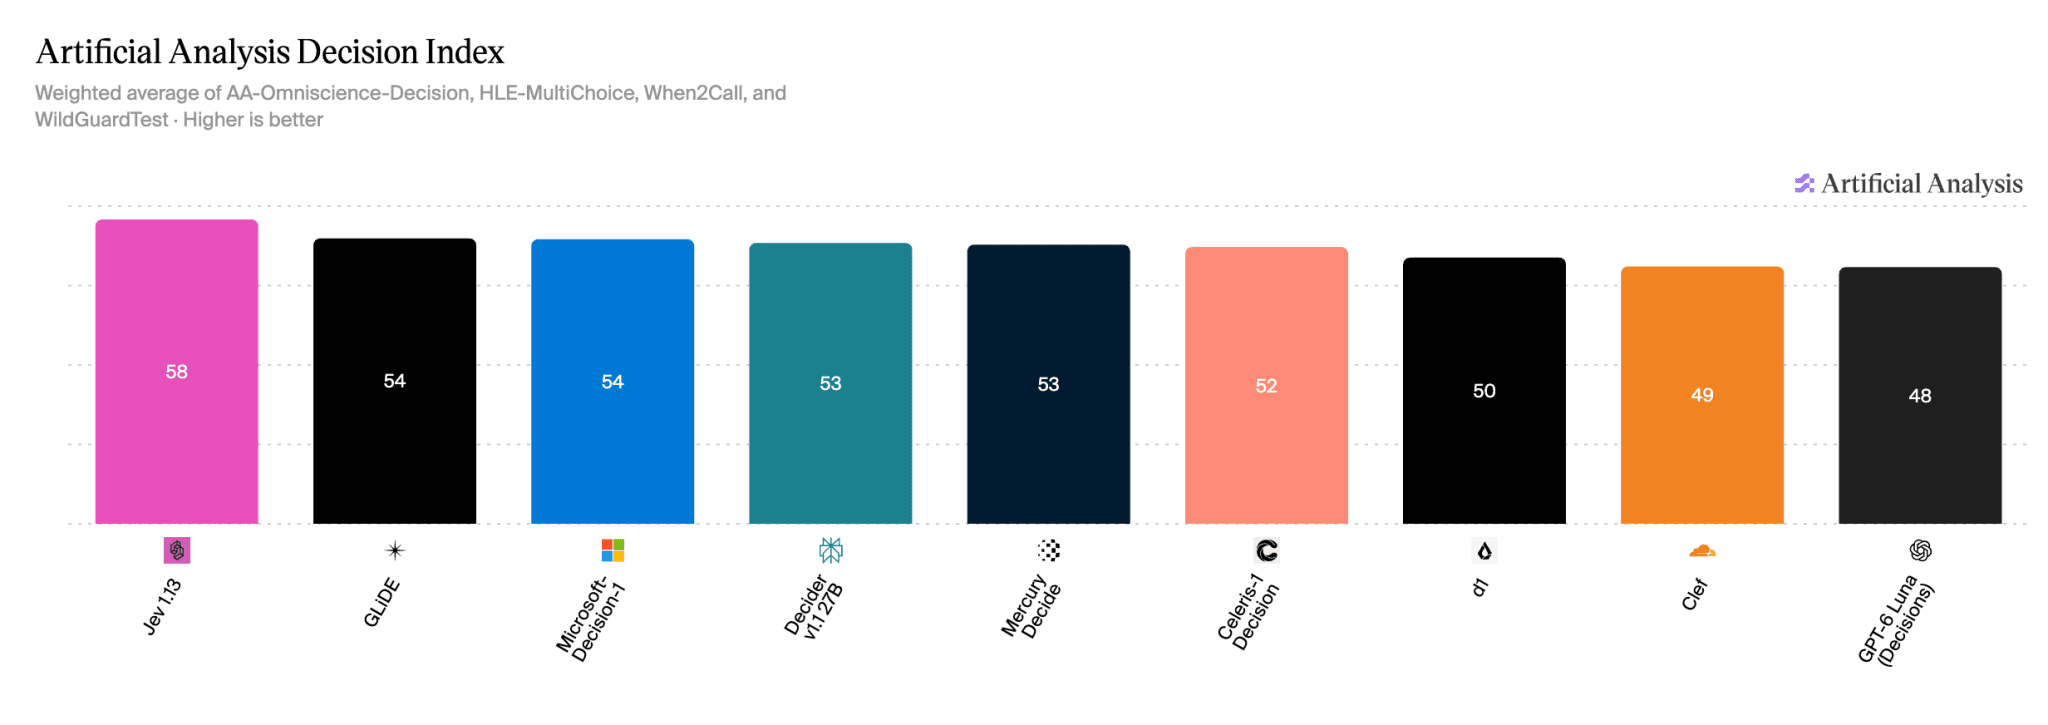
У моделей решений появился общий экзамен. Такие модели получают список допустимых ответов и возвращают выбор с вероятностями вместо свободного текста. Три недели назад я писал, что независимой проверки для всей категории пока нет, а теперь Artificial Analysis запустила Decision Index. В него поровну входят знания вместе с галлюцинациями, рассуждение, вызов инструментов и распознавание опасных запросов. На старте среди моделей решений лидировал Jev 1.13 с 58 баллами. Haiku 5.5 при низкой глубине рассуждений набирает 61, но отвечает за 1.4 секунды против 0.13 у Jev и стоит $184 за миллион задач против $42. По выводам AA, в классификации и выборе инструментов модели решений не уступают языковым, в знаниях и рассуждении отстают, а точность у всех ниже заявленной уверенности.
16 октября первое место заняла Liquid d1-ultra с 65 баллами против 57 у Jev 1.14. Рост дала осторожность: когда d1-ultra не знает ответа, она в 85% случаев так и говорит, у прошлой d1 было 2%, но и точность упала с 41% до 32%.
Perplexity выложила веса pplx-decider v1.2. Использование модели на 27 млрд параметров стоит 2 цента за миллион токенов, на 4 млрд параметров — цент. Две недели назад прошлая модель на 27 млрд параметров в Decisions API стоила 4 цента за миллион токенов.
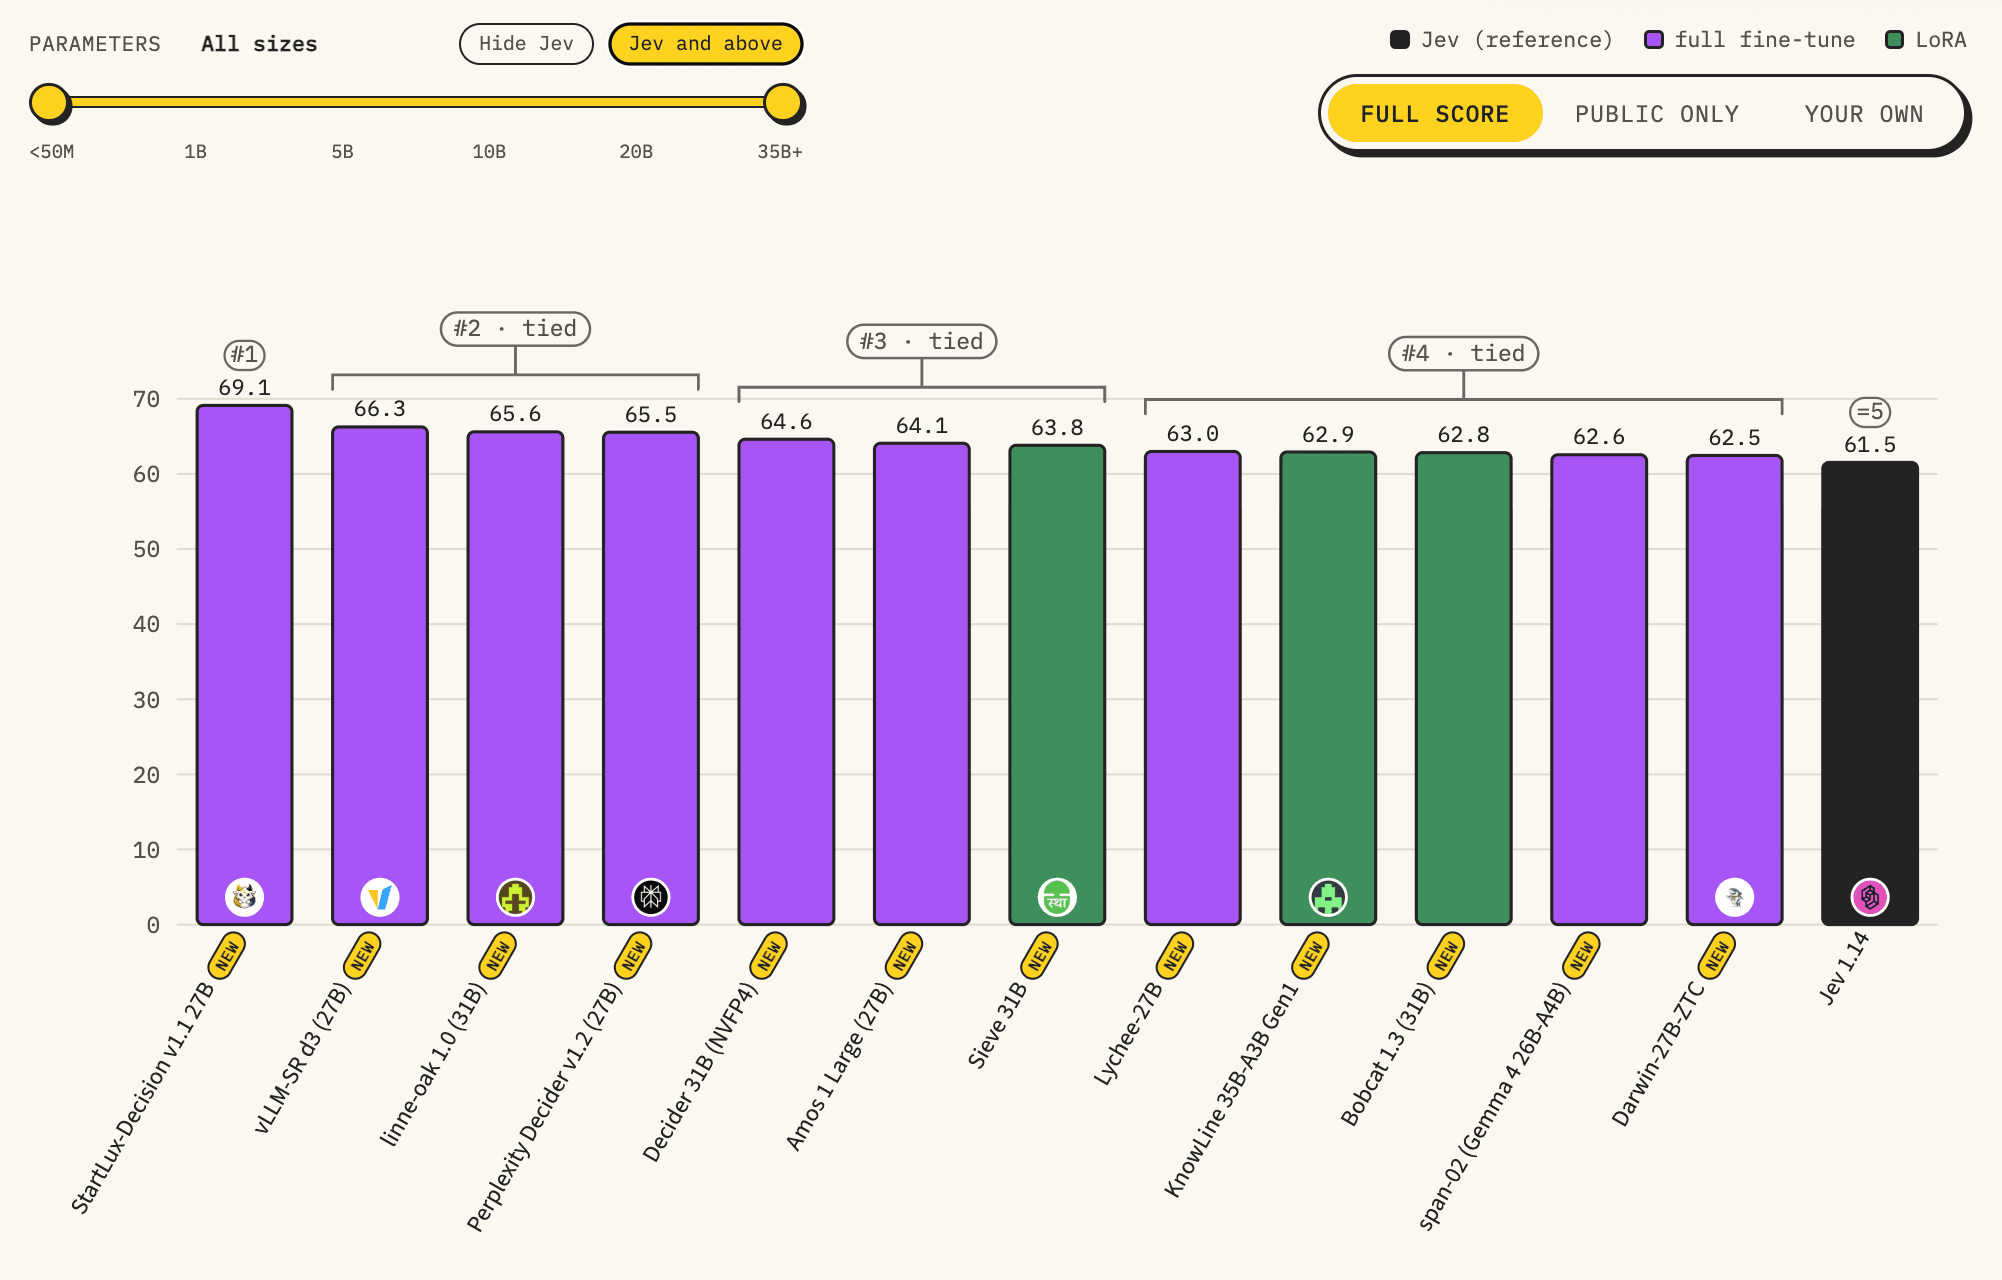
Decision 3.0 от vLLM Semantic Router, семейство open weight моделей от 0.6 до 27 млрд параметров под Apache 2.0, по замерам самих авторов возглавило оба рейтинга от создателей Jev из Typesafe AI. В комментариях сразу спросили, на чём теперь держится оценка этой компании в $7.5 млрд.
Джастин Уберти, глава Realtime AI в OpenAI, рассказал, что голосовые приложения на Live API теперь могут через Decisions API быстро выбирать инструмент и оставлять полноценную LLM для редких запросов.
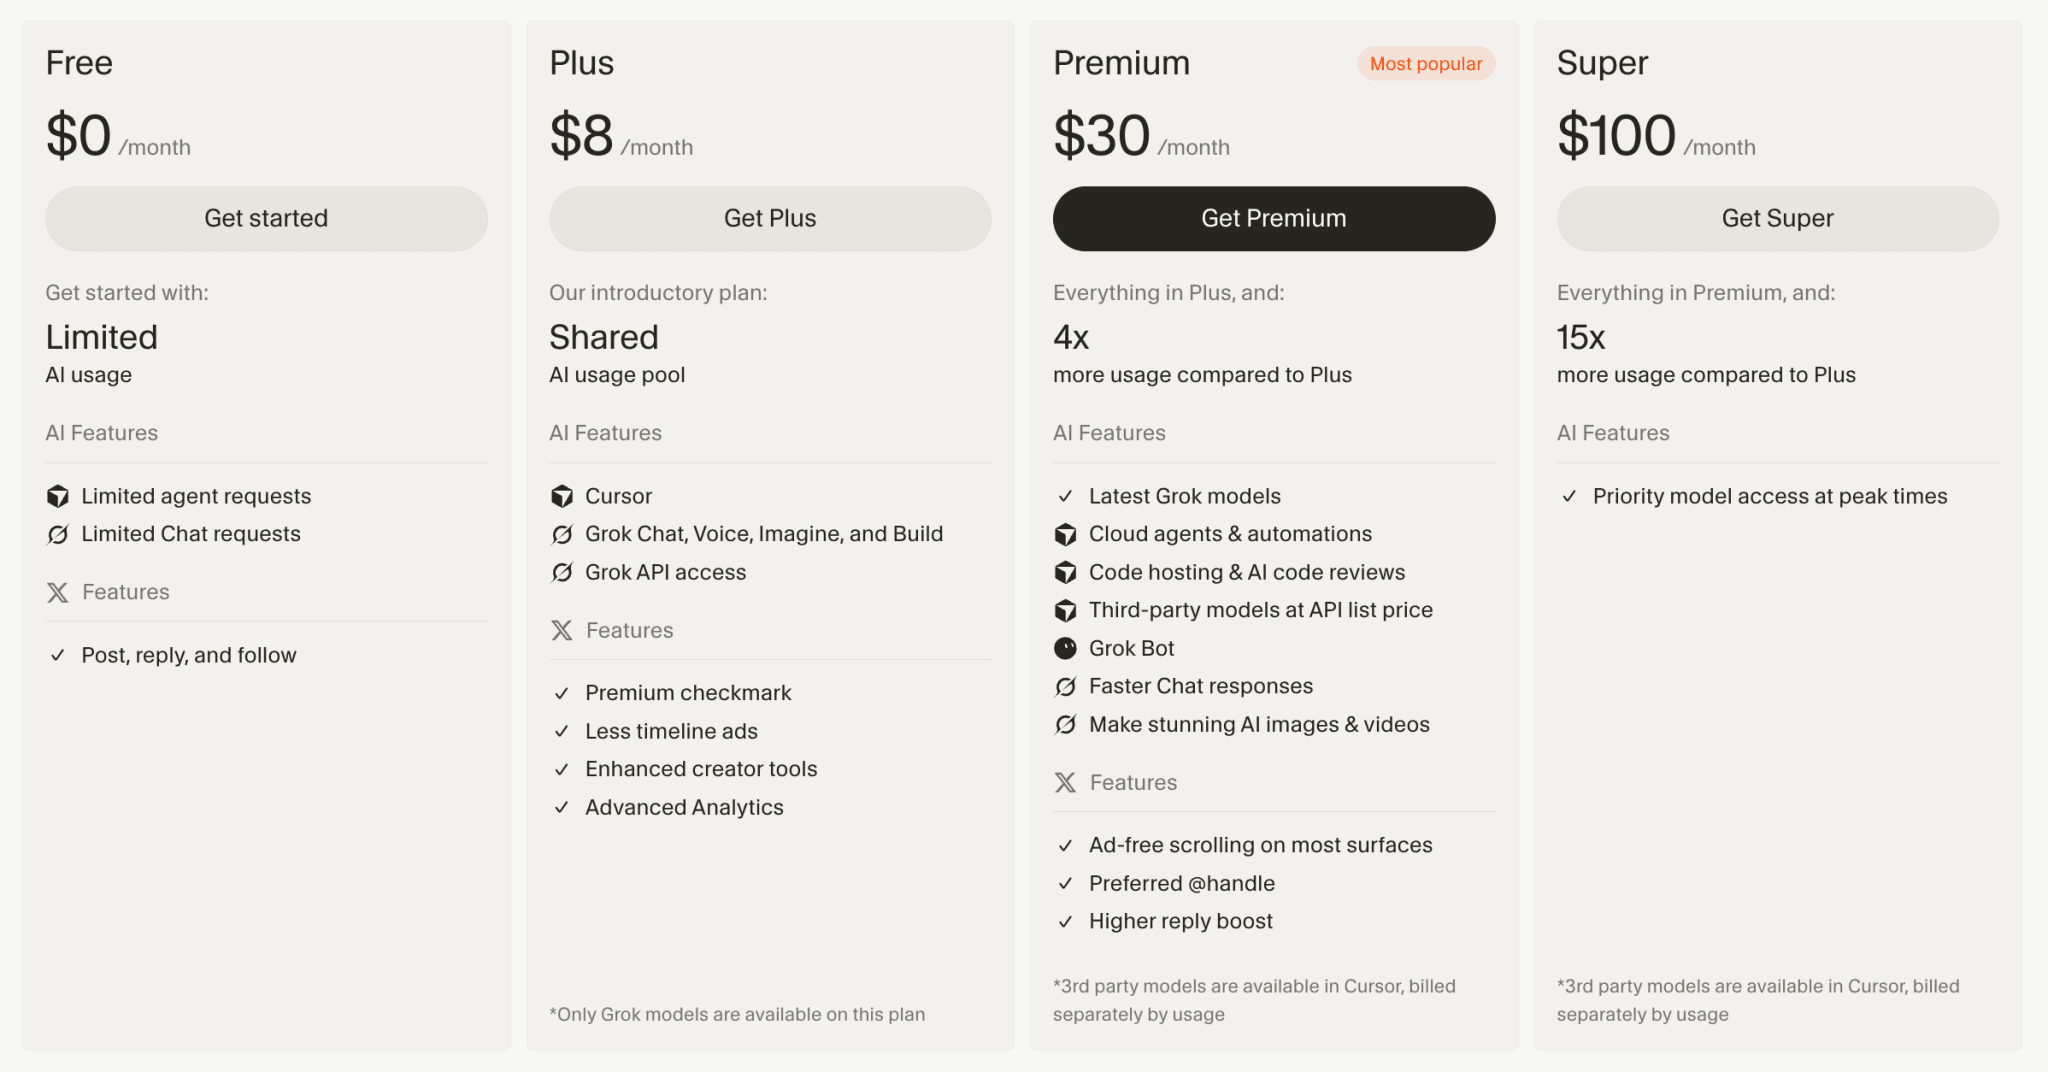
Cursor, который SpaceX купила в июне, вошёл в X Subscription, общую подписку на продукты Grok и X. Нынешние подписчики могут остаться на своём тарифе. На новых платных тарифах Cursor, Grok Build и другие продукты Grok делят один пул использования, а лимит на программирование с моделями Grok вдвое больше, чем в равноценном тарифе Cursor. Чтобы освободить место под Grok, сторонние модели переезжают на цены API. На странице тарифов в самом дешёвом платном Plus за $8 есть только модели Grok, а начиная с Premium за $30 сторонние модели оплачиваются отдельно по прайсу API, без включённого объёма. Тарифа за $20 там больше нет.
Министерство коммерции и Министерство науки и технологий Китая 16 октября опубликовали проект нового каталога технологий, экспорт которых запрещён или ограничен. В нём 40 новых позиций, из них 23 про ИИ: большие модели, агенты, вычислительные кластеры и обработка информации. Генерацию и мутацию вредоносного кода с помощью ИИ предлагают запретить, поиск уязвимостей с ИИ ограничить. Технологии, которые уже стали публичными через open source или научные статьи, под контроль не попадают. Доступ к модели через API, приложение, веб-интерфейс или SaaS экспортом не считается, а развёртывание модели за рубежом считается. Пока каталог не вступил в силу, экспортёры должны регистрировать перечисленные технологии перед вывозом.
На r/LocalLLaMA испугались, что open weight релизов от Qwen и DeepSeek станет меньше. Эли Бакуш, исследователь Prime Intellect, возражает, что это пока проект, он касается и закрытых моделей, а open weight модели, по его прочтению, получают лицензию почти автоматически.
Мы продолжаем исследование "ИИ на работе: экономия времени или новая нагрузка?". Хотим понять, сколько времени ИИ на самом деле экономит на рабочих задачах, если учесть подготовку запросов, проверку и переделки, и что при этом происходит с качеством и нагрузкой. Спасибо всем, кто уже ответил, данные получаются интересные, и каждая новая анкета делает картину точнее.
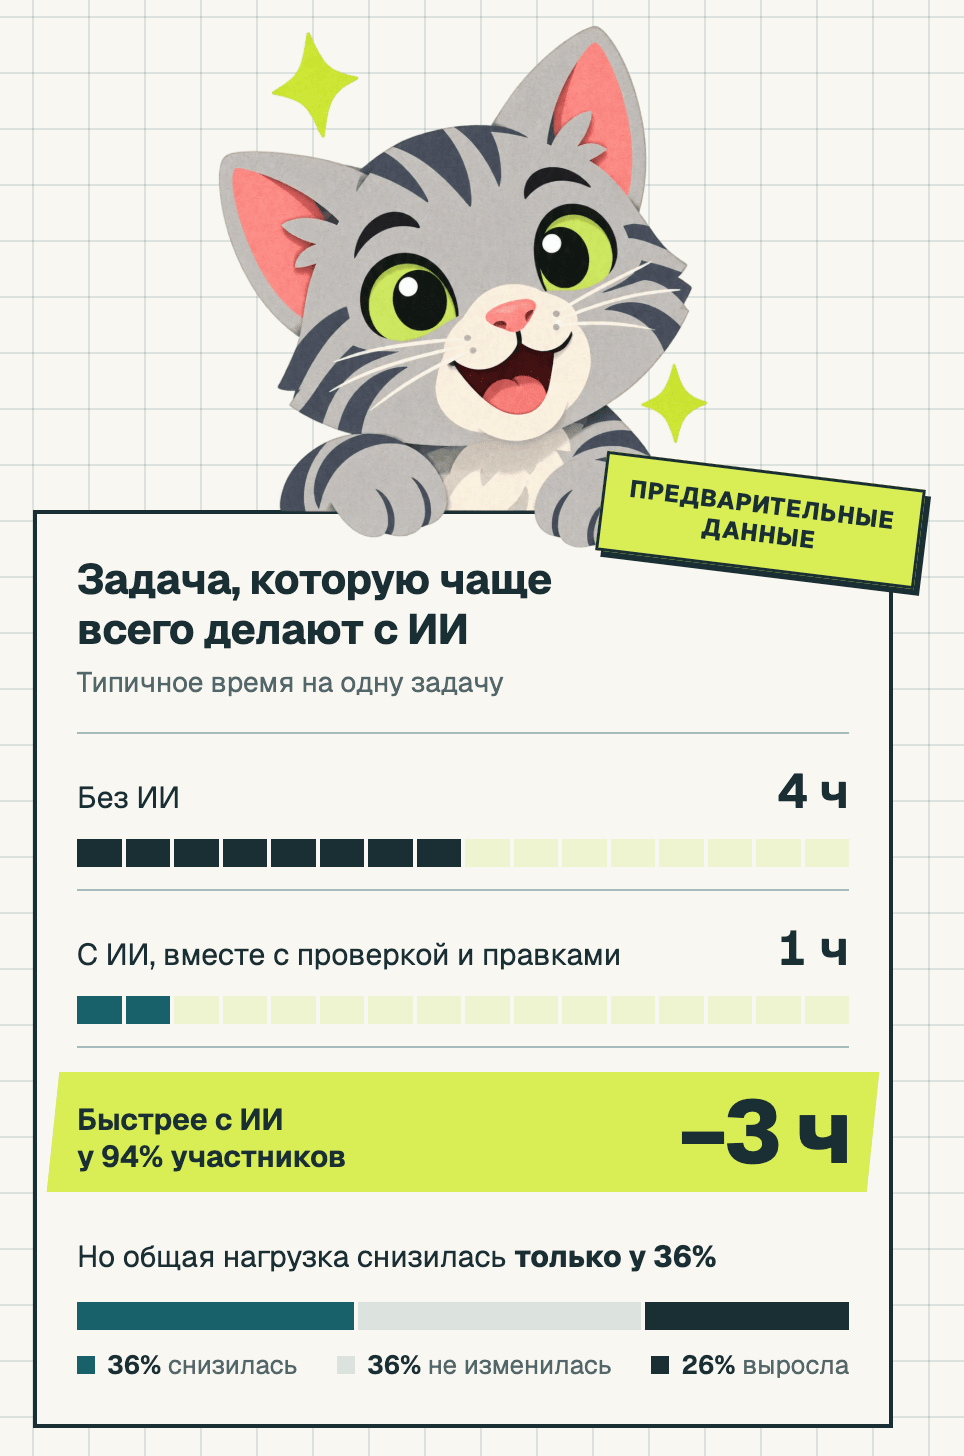
Если вы работаете в России или за рубежом и ещё не участвовали, заполните анкету. Ваш опыт важен, даже если вы не используете ИИ в работе. Это около 10 минут и полностью анонимно. Результаты опубликуем в обобщённом виде в конце октября.
Оставайтесь любопытными.