Галлюцинации недели: Claude Opus 5.5, GPT-6 Sol и опрос о том, как вы используете ИИ на работе
Написать запрос, проверить ответ, переделать результат. Нам стало интересно, сколько рабочего времени ИИ экономит после всех этих действий и что происходит с качеством. Давайте посчитаем вместе. Но сначала расскажем, что произошло за прошедшую неделю.
Anthropic выпустила Claude Opus 5.5 для Claude Code и API. Компания обещает уровень Fable 5.1 для большинства задач и называет главным улучшением не очередные проценты в одном тесте, а стоимость обычной работы: при стандартных настройках задача должна обходиться примерно на 40% дешевле, чем на Opus 5. Прейскурант API снизился на 20%, до $4/$20 за миллион токенов. Чтение из кеша $0,20 вместо $0,50.
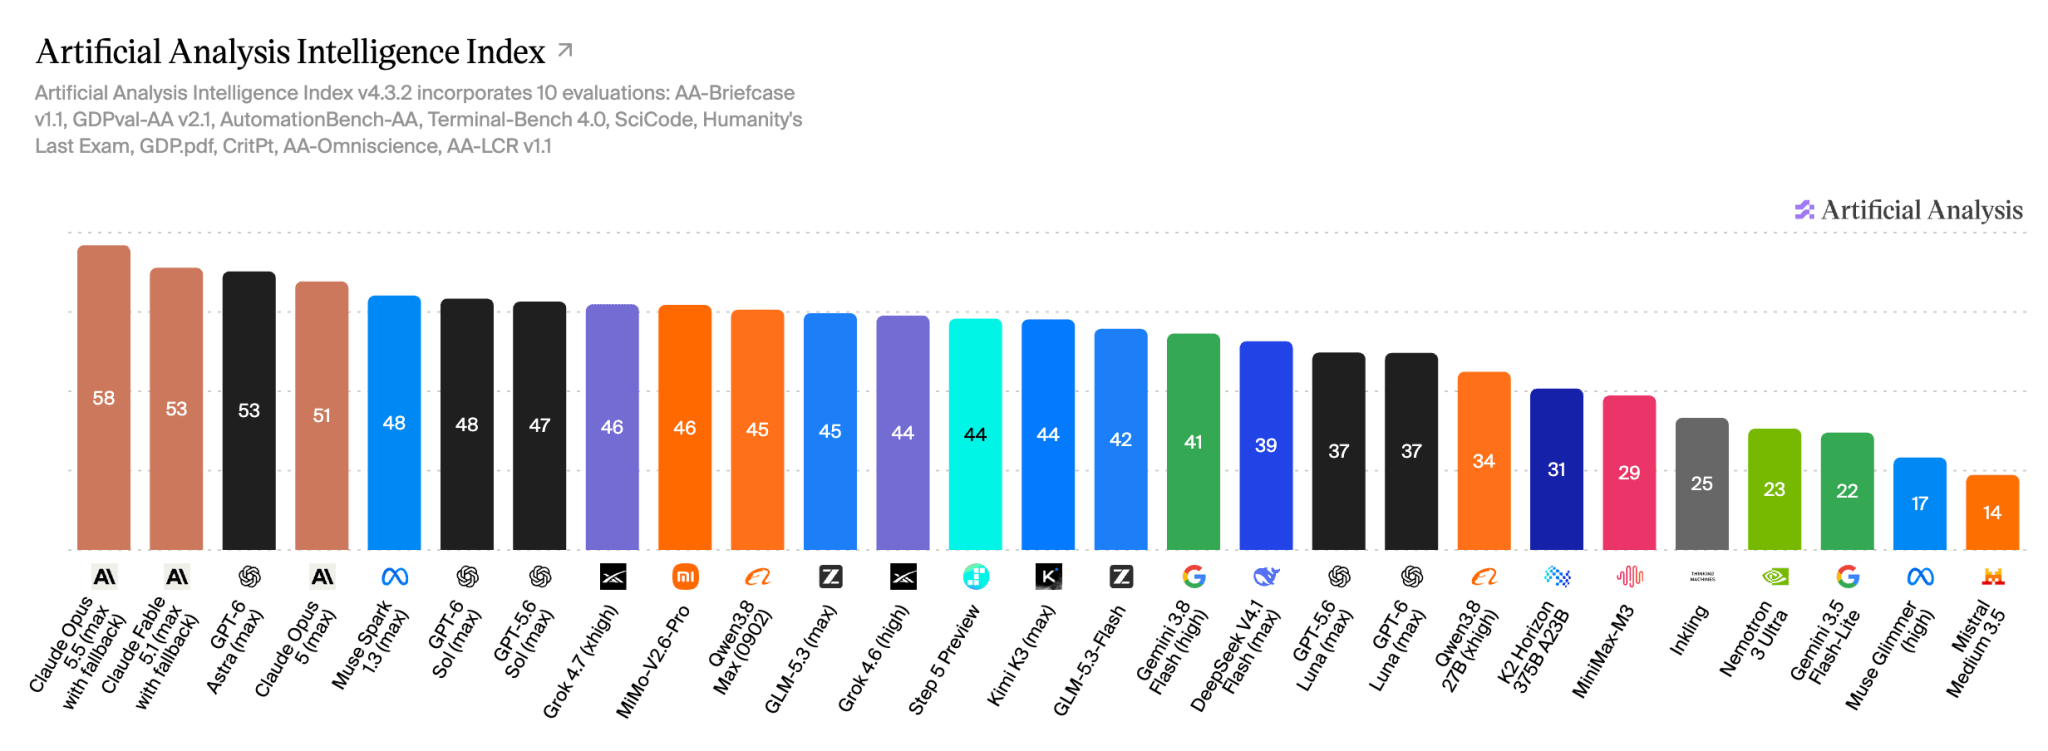
Artificial Analysis прогнала модель на пяти уровнях reasoning effort: Max набрал 58 баллов в составном индексе задач на рассуждение, код и работу с документами, но потратил $5,98 на задачу против $5,86 у Opus 5 на его максимуме. Новая модель генерировала примерно 119 тысяч выходных токенов на задачу вместо 73 тысяч. То есть цена токена упала, а счёт за самый напряжённый прогон не снизился.
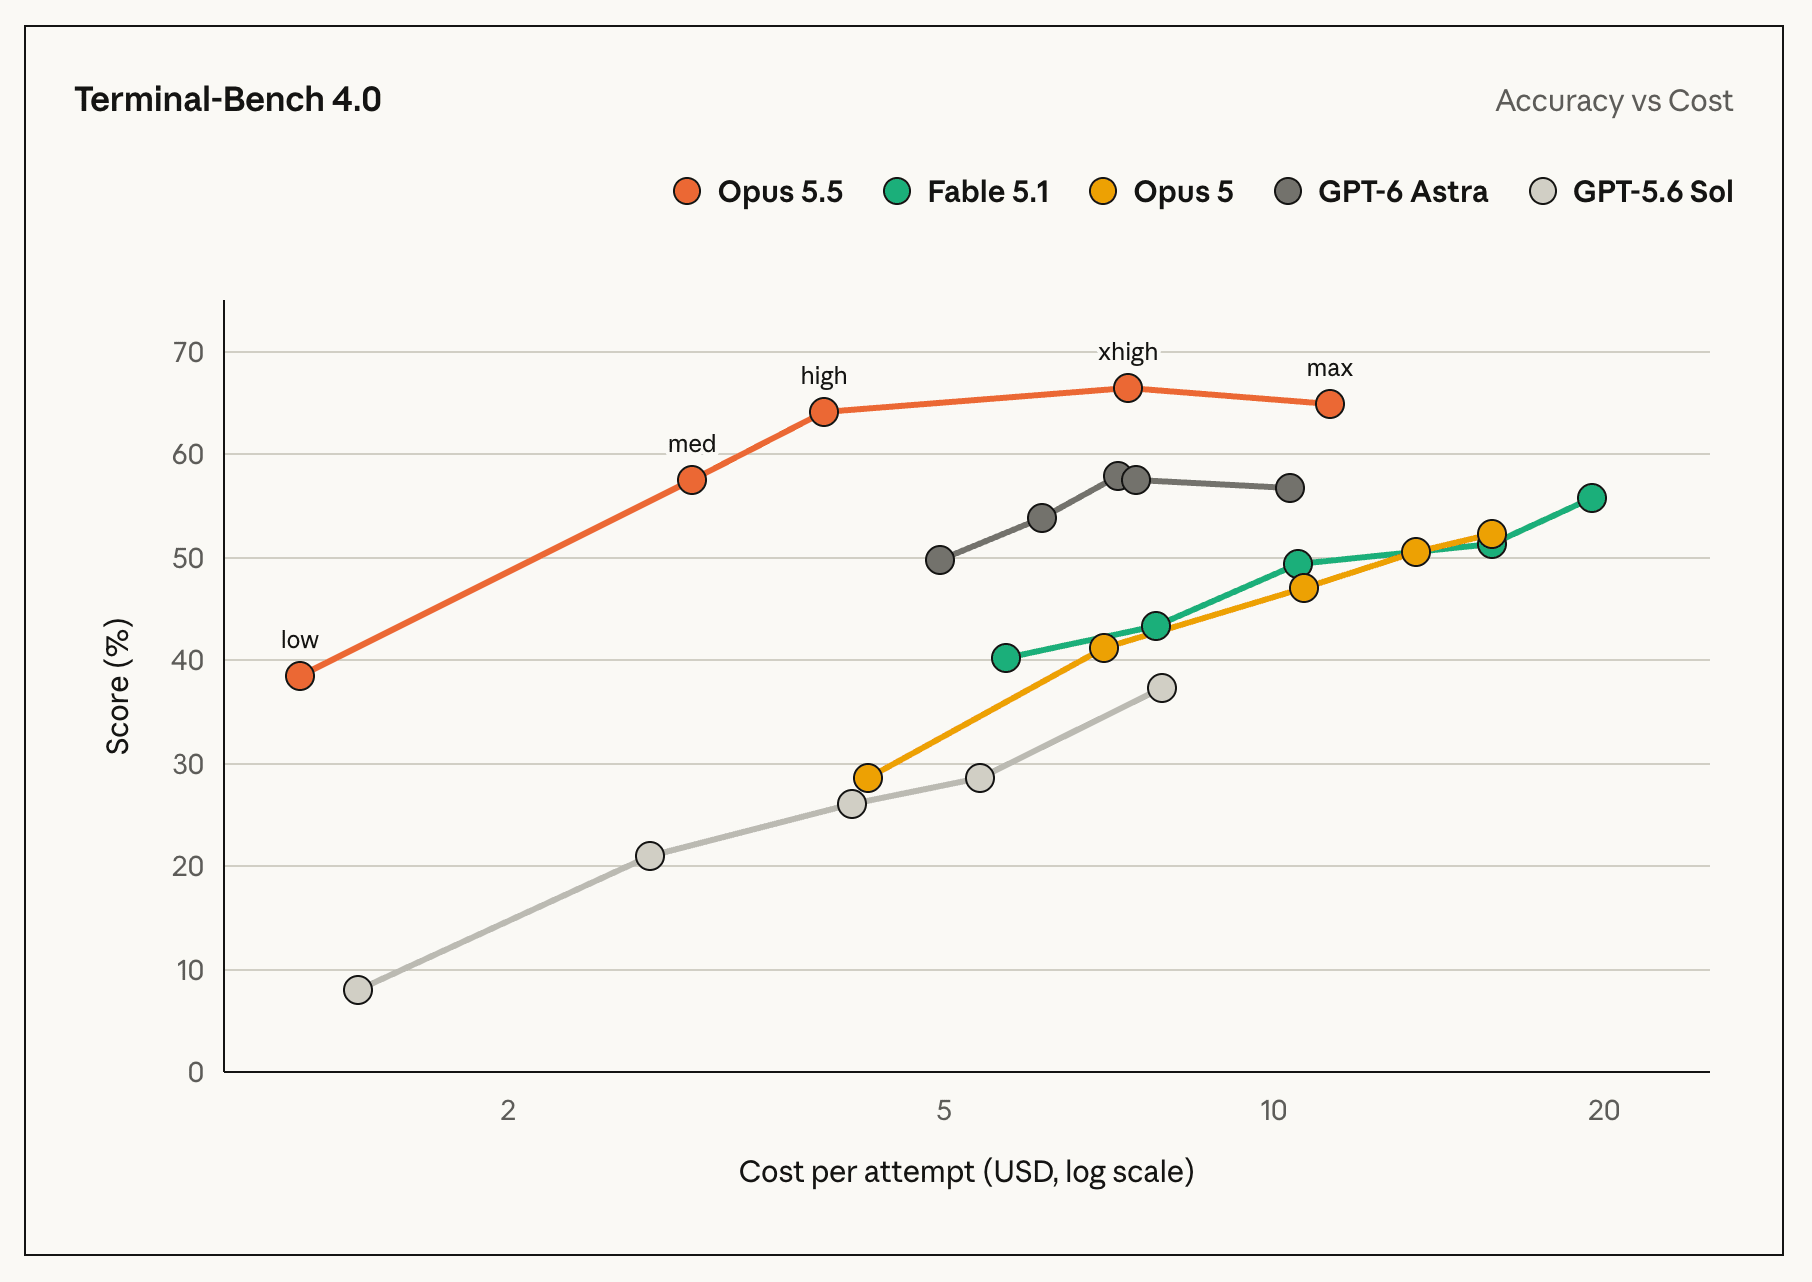
В материалах Anthropic особенно заметен сдвиг к агентной разработке. На Terminal-Bench 4.0, где агент выполняет многошаговые задачи в терминале, компания сообщает 66,4% для Opus 5.5 на предпоследнем уровне reasoning effort против 52,3% для Opus 5 в своём прогоне. Эти цифры получены с разными режимами усилий и в собственной конфигурации теста. Opus теперь можно использовать на Medium, а более дорогой режим включать там, где задача встала колом.
OpenAI выпустила GPT-6 Sol и Luna. Обе наследуют наработки Astra, но рассчитаны на больший объём повседневных запросов. В коротком контексте стандартная цена API составляет $2/$10 для Sol и $0,10/$0,50 для Luna за миллион токенов; при длинном контексте будет дороже. Модели появились в Codex, ChatGPT Work и API, а Luna доступна и на бесплатном тарифе.
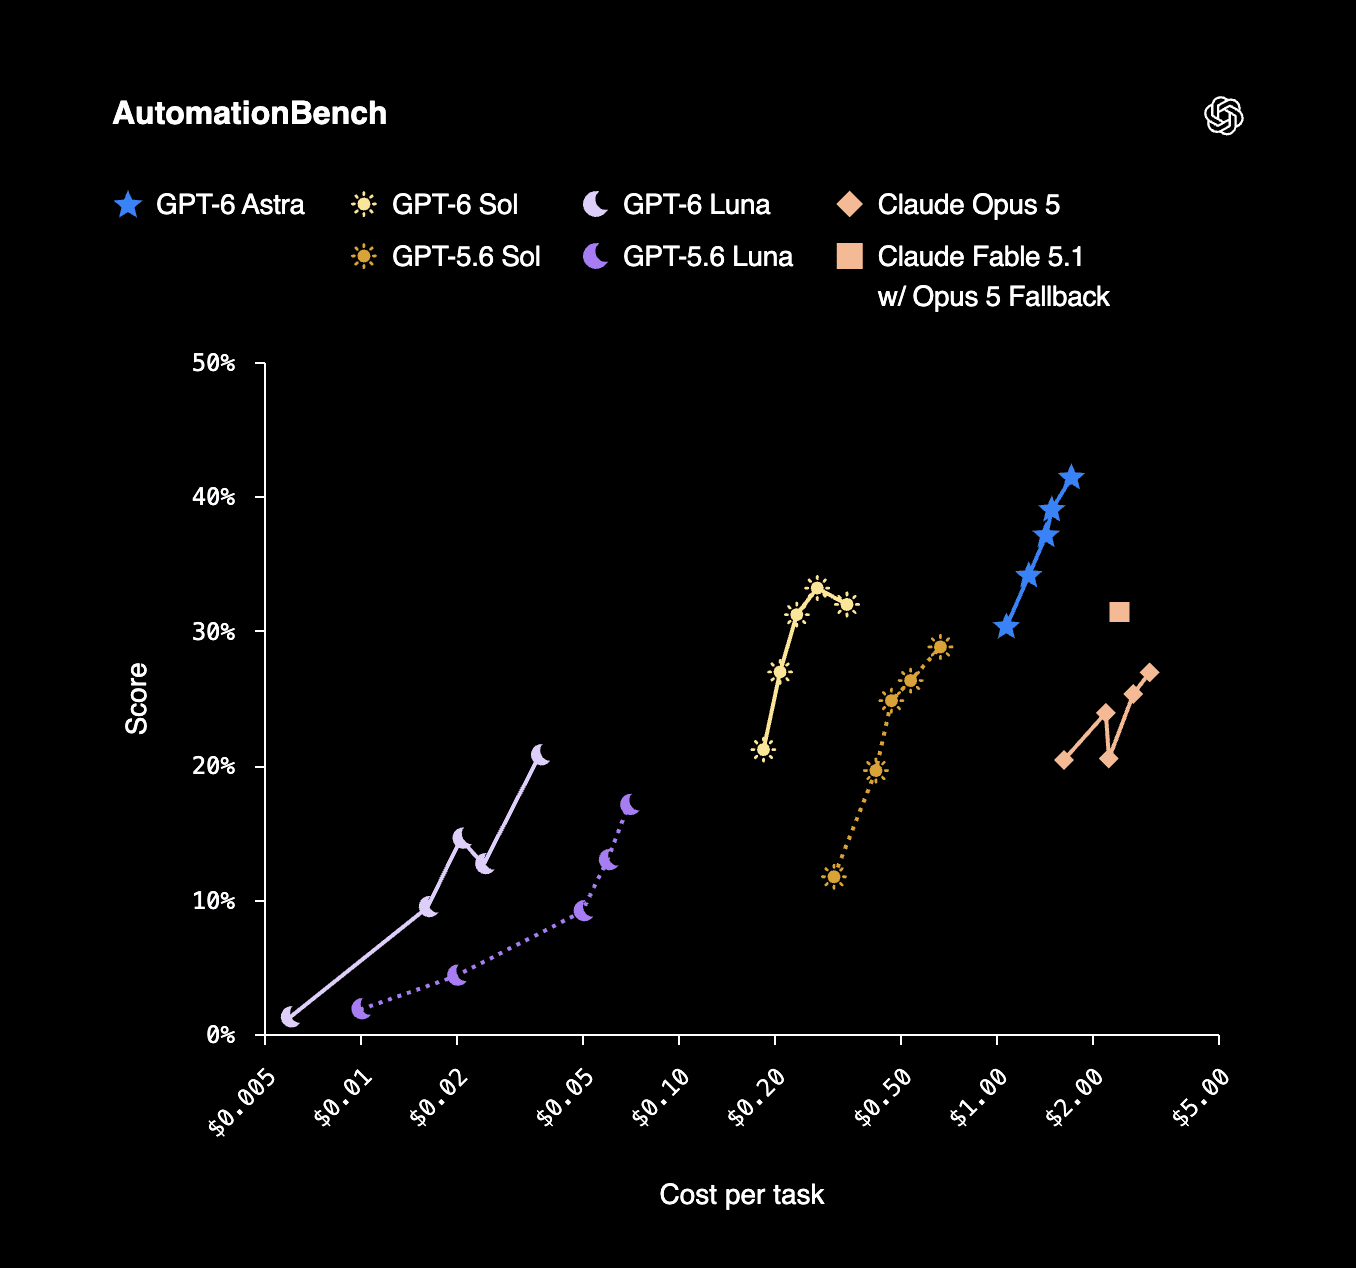
Artificial Analysis отмечает улучшение соотношения цены и качества у Sol и Luna. Для длинного исследования или сложной миграции я бы сначала смотрел на успешность задачи в конкретной обвязке и полный расход токенов.
Xiaomi ответила на ценовую гонку: веса MiMo-V2.6-Pro-RL и MiMo-V2.6-Flash-RL опубликованы под MIT. У старшей модели 1,02 трлн параметров суммарно, но на каждом токене задействуется 42 млрд, это MoE, где из большой сети включается только нужная часть. Модель принимает текст, изображения, аудио и видео, контекст 1 млн токенов.
Xiaomi описывает единый цикл RL: модель обучали на обратной связи за действия в программировании, работе с инструментами, визуальных и киберзадачах. Часть рецептов и сред команда выложила вместе с весами. В измерениях Artificial Analysis MiMo получила 46 баллов общего индекса при примерно $0,13 на задачу их набора.
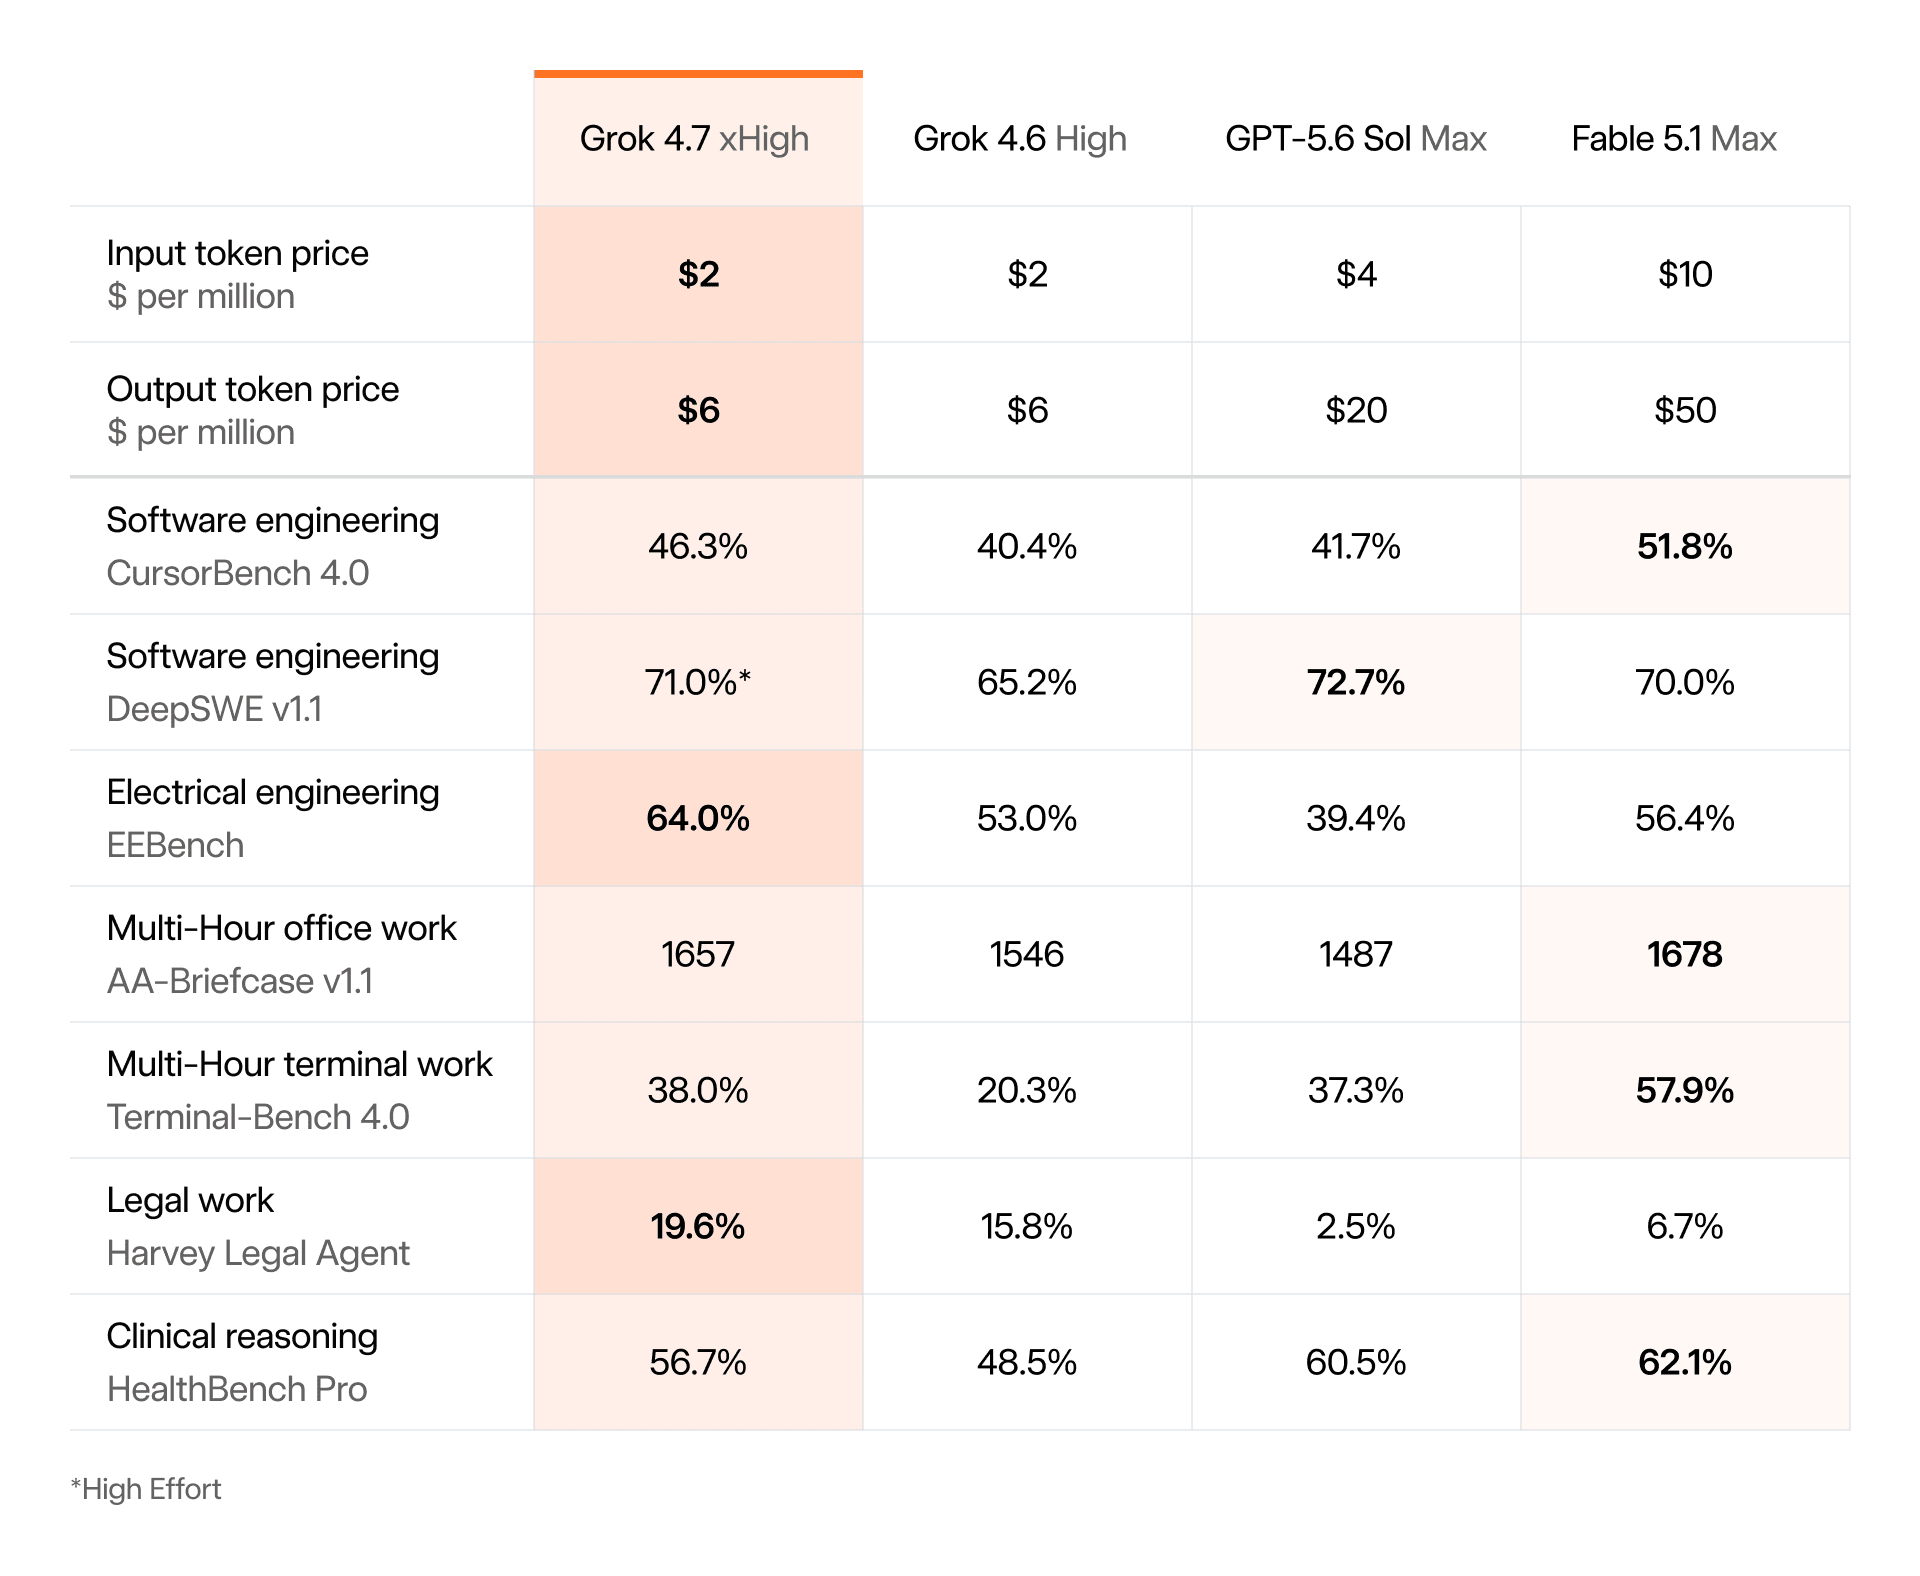
SpaceXAI представила Grok 4.7 как модель для длинных кодинг-сессий и работы с информацией, сохранив заявленные цену и скорость уровня 4.6. Artificial Analysis дала ей 46 баллов в общем индексе, всего на два больше предыдущей версии. Зато в индексе кодинг-агентов Grok вместе с собственной обвязкой Grok Build поднялась с 47 до 56. В других задачах картина неровная, у аналитиков есть улучшения в терминале и просадки в проверке длинного контекста и автоматизации приложений. На задачу модель тратила заметно больше токенов.
У Jev появился показательный сосед — открытый CLM. Про Jev мы писали на прошлой неделе и разбирали API решений и пятнадцать проектов на нём.
CLM строит представления состояния и возможных действий отдельно, сравнивает их и отдаёт оценки через интерфейс, совместимый с TypeSafe. В основе опубликованной версии Qwen3-8B; код доступен под Apache-2.0, так что его можно развернуть у себя и проверить на собственных задачах. Авторы сообщают о скорости до девяти раз выше Jev в отдельных сценариях и высоких результатах в проверке решений кодинг-агентов. Их тесты собраны на небольших отложенных наборах, общего независимого экзамена для всей категории пока нет.
Meta рассказала на Connect о следующих возможностях Muse. О первом запуске агента мы писали две недели назад. У Muse появится собственный почтовый адрес, агенту можно будет писать напрямую. Компания анонсировала голосовой разговор и новые подключения к магазинам и рабочим сервисам. Meta также обещает вывести Muse на свои очки в ближайшие месяцы, агент сможет учитывать то, на что смотрит владелец.
Мы ранее писали про отдельную виртуальную машину Muse и проверяющего агента Sentinel. Теперь масштаб последствий этой схемы понятнее. Агент с собственным почтовым адресом, доступом к покупке и камерой на очках получит куда больше поводов ошибиться, чем чат-бот в отдельном окне. Meta описывает подтверждение чувствительных действий и разграничение доступа к паролям. Это полезные инженерные решения, но проверить их по презентации нельзя; настоящую надёжность покажут задачи и сбои после расширения доступа.
Gemini 3.8 Flash вышла ещё 2 сентября. Теперь к ней накопились измерения, позволяющие понять место модели между дорогими флагманами и совсем дешёвыми помощниками. Artificial Analysis даёт 41 балл общего индекса и около 300 выходных токенов в секунду при измерении через API Google. Быстрый вывод не равен быстрому первому ответу, на этой же странице TTFT (время до первого токена) заметно выше медианы сопоставимых моделей.
На ARC-AGI, наборе задач на поиск правил в незнакомых головоломках, Flash решила 89,2% заданий второй версии при высоком reasoning effort. На третьей версии — уже 10,4% со стандартной обвязкой и 35% с обвязкой поставщика, которая сохраняет состояние рассуждения между вызовами.
Qwen-Image 2.1, представленная 20 сентября, объединяет генерацию и редактирование в одной модели. В генеративном компоненте 7 млрд параметров; модель умеет сразу выдавать изображение с прозрачным фоном, принимать до десяти референсов и менять выбранные области.
С весами есть существенное условие. Текст лицензии на Hugging Face разрешает использовать материалы модели для исследований и оценки, а для коммерческого применения требует отдельной лицензии. В обсуждении на Reddit отдельно спорили о правах на готовые изображения.
Интересно, а вот так она могёт?
Hugging Face представила кандидат версии tokenizers v1. Токенизатор превращает текст в номера фрагментов, которые понимает модель. На Apple M4 Max команда измерила ускорение этой операции в 3–30 раз относительно версии 0.23 на десяти семействах моделей при одном потоке. Идентификаторы токенов при этом сохраняются, оптимизация не должна незаметно изменить вход модели. Повторное использование уже разобранных слов и буферов сокращает лишнюю работу; для одинаковых префиксов выгода выше, для непохожих текстов ниже.
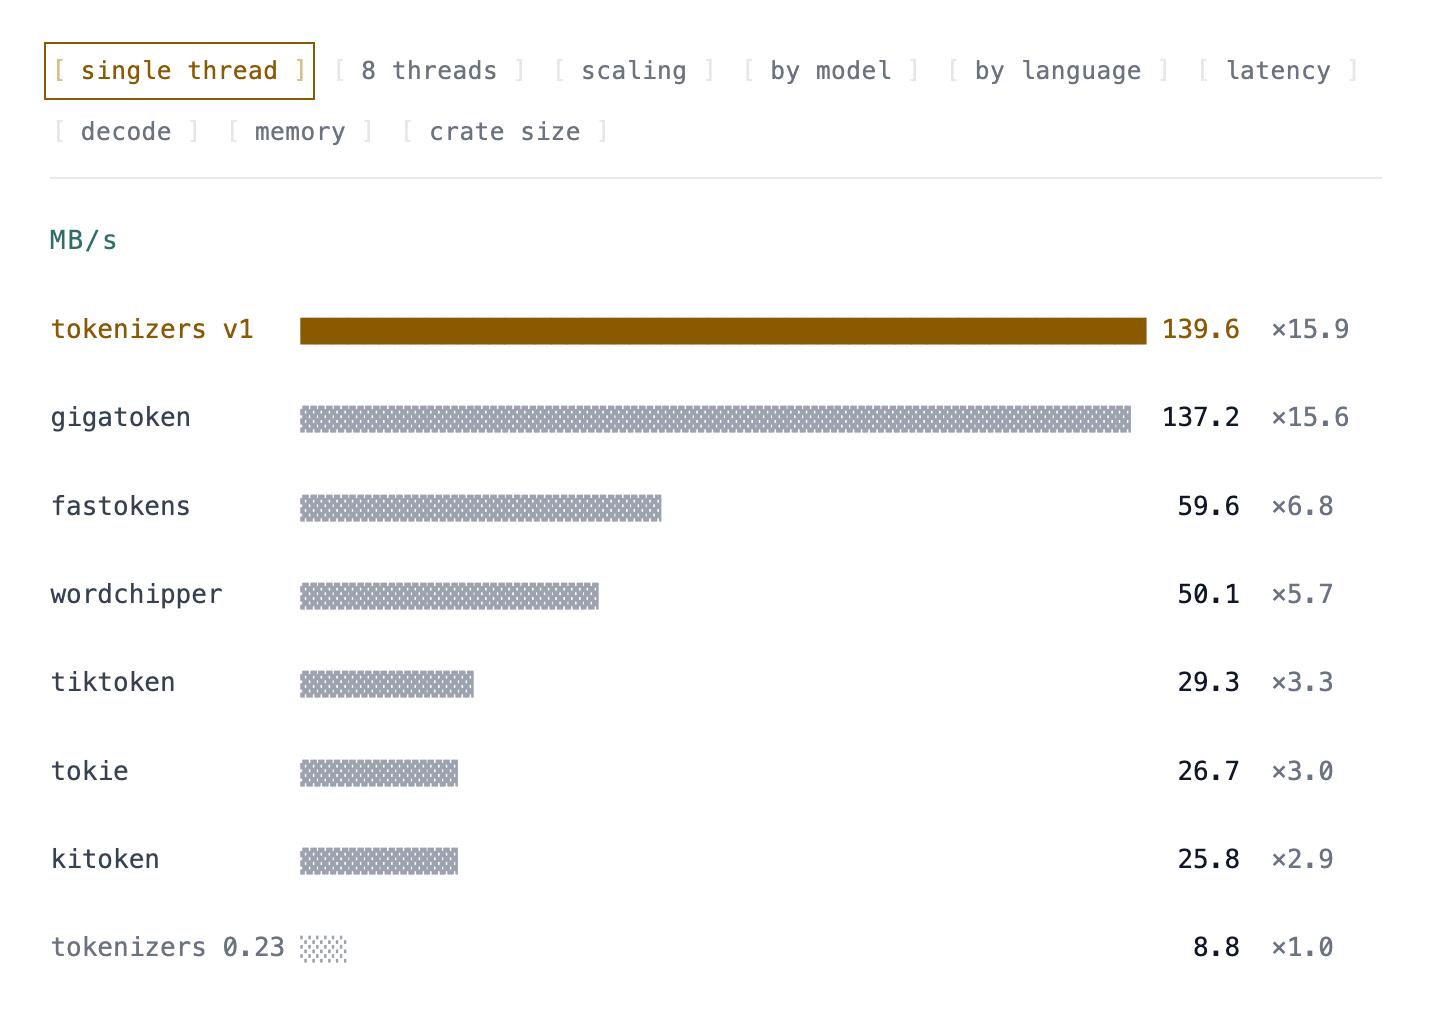
Пока это предварительная Rust-версия, полный Python API и стабильная 1.0 ещё в работе. Бежать и переписывать действующий сервис ради максимальной цифры из бенчмарка рано. Но если в вашем пайплайне токенизация уже стала узким местом, авторы опубликовали методику и команду для повторения замеров на своём железе.
Ребята, у нас небольшой анонс! Мы запустили исследование «ИИ на работе: экономия времени или новая нагрузка?». Нам стало интересно, сколько времени ИИ экономит на реальных рабочих задачах с подготовкой, проверкой и переделками. Что при этом происходит с качеством задач и общей нагрузкой на сотрудников?
Если вы сейчас трудоустроены в России или за её пределами, расскажите, как проходит ваша ИИ-трансформация. Поделитесь опытом, даже если совсем не используете ИИ в работе. Анкета займёт около 10 минут, всё анонимно, итоги будем подводить в обобщённом виде. Результаты опубликуем в конце октября.
И да, это не реклама, исследование проводим мы, Контролируемые галлюцинации. Нам правда интересно замерить реальный эффект от ИИ, а не показать красивую цифру в отчётах для стейкхолдеров.
Оставайтесь любопытными.
Пишу об искусственном интеллекте, языковых моделях и инструментах для разработчиков. Тестирую модели и сервисы на реальных задачах, а выводами делюсь в телеграм-канале.