Галлюцинации недели: Gemini 4 Argon, OpenAI DevDay и Sonnet 5.5 с большим аппетитом к токенам
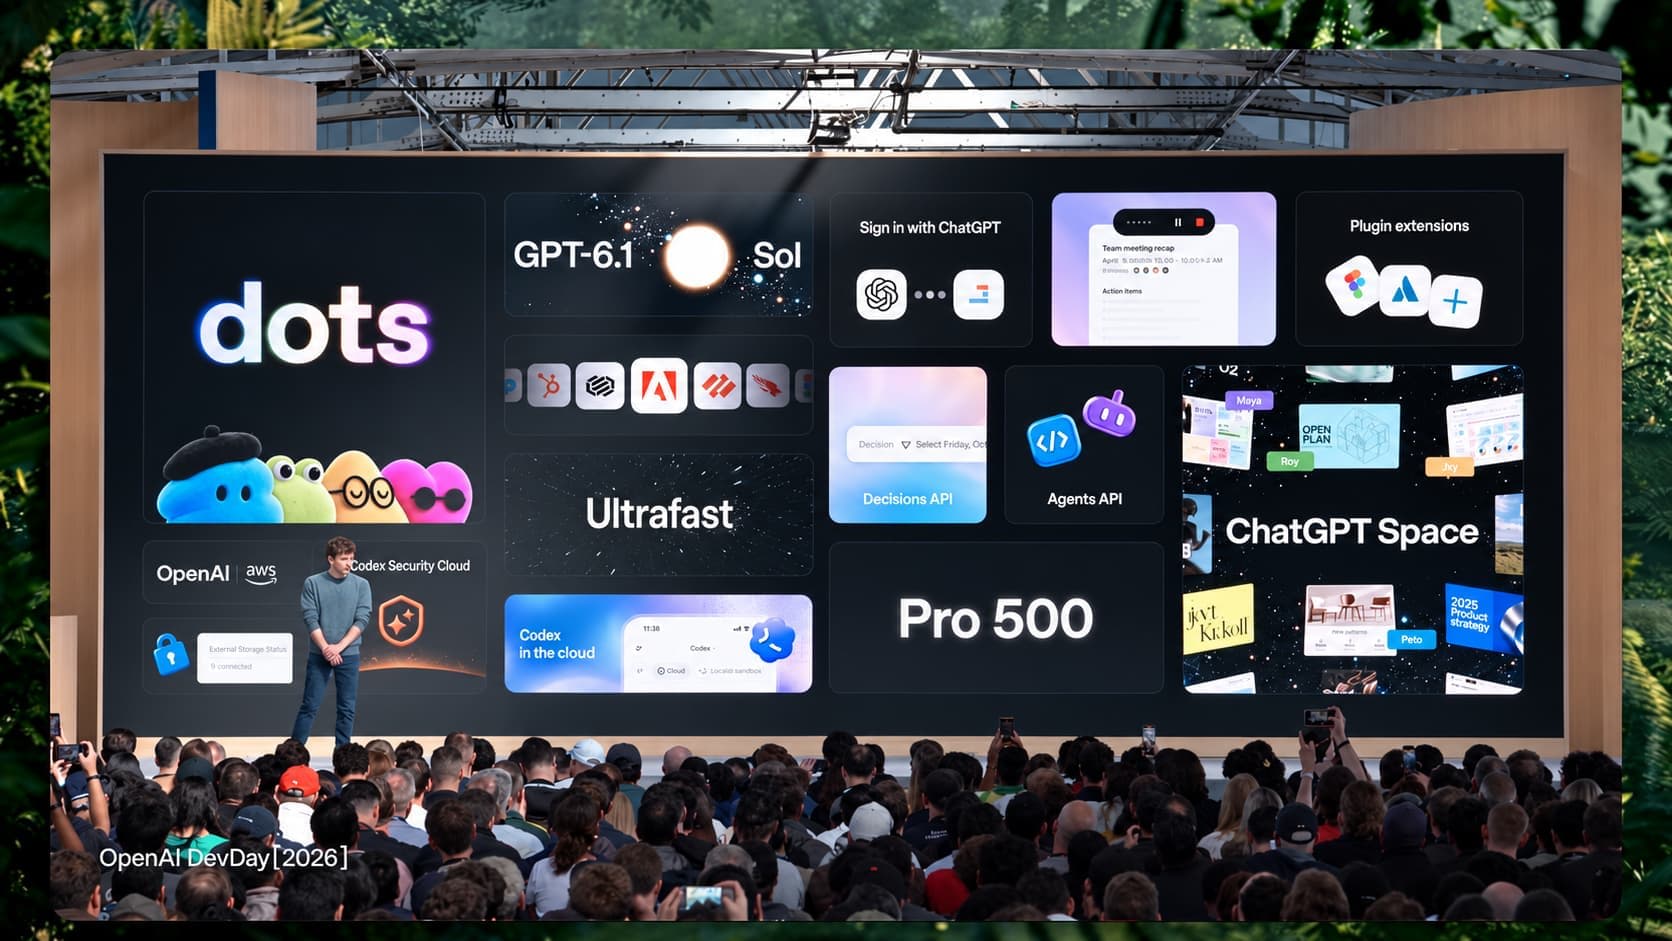
OpenAI на DevDay много сделала для того, чтобы в ChatGPT можно было работать всерьёз и надолго. Полезных возможностей прибавилось, но вместительную подписку заодно сделали менее щедрой. Мне нравится, куда развивается продукт, а вот снижение лимитов нравится меньше.
Google анонсировала Gemini 4 Argon, но попробовать её пока могут выбранные участники программы киберзащиты Fairwind. Разработчикам, компаниям и обычным пользователям доступ обещают позже, начиная с платного API и Google AI Ultra. Стартовый прайс API составляет $2/$10 за миллион токенов, после демо периода будет $4/$20. Даты окончания скидки нет. Лимит ответа вырос с 64 тысяч до миллиона токенов; это отдельная величина от размера контекста, который тоже составляет миллион. Длинное рассуждение можно приостанавливать и продолжать следующим запросом.
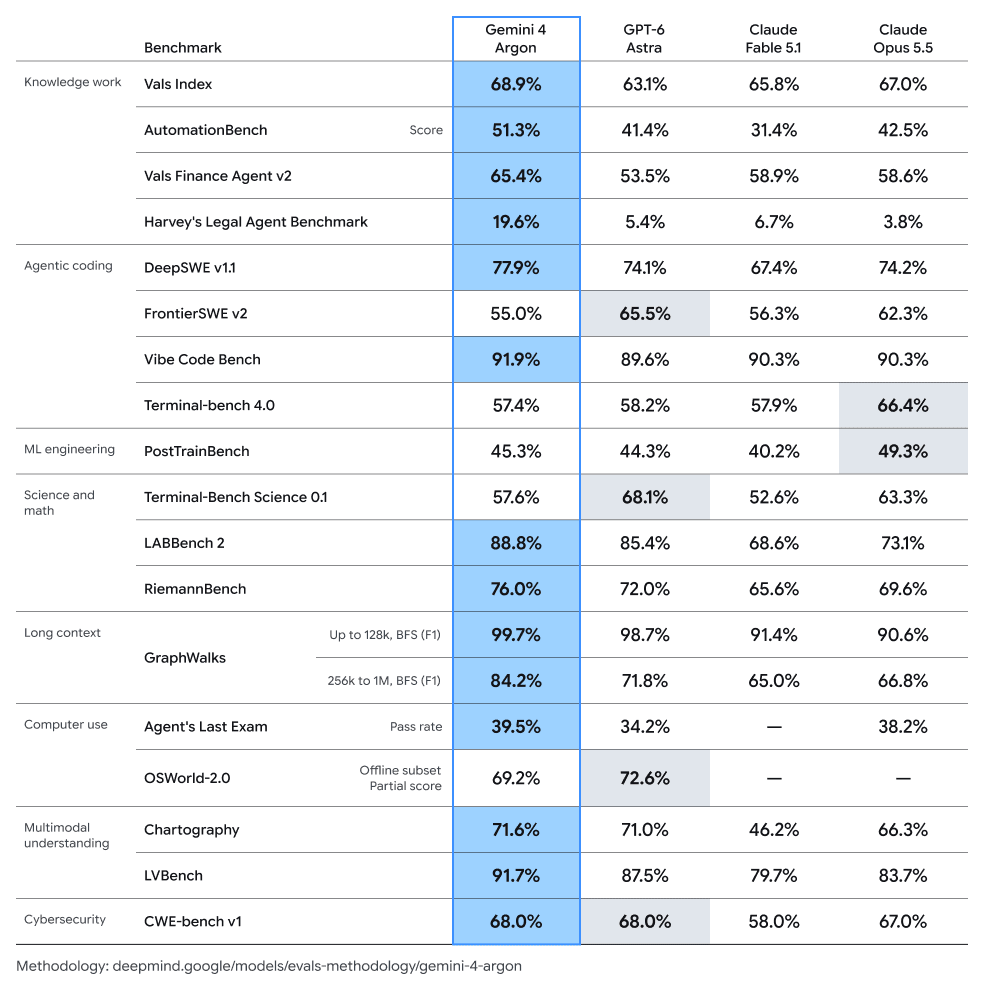
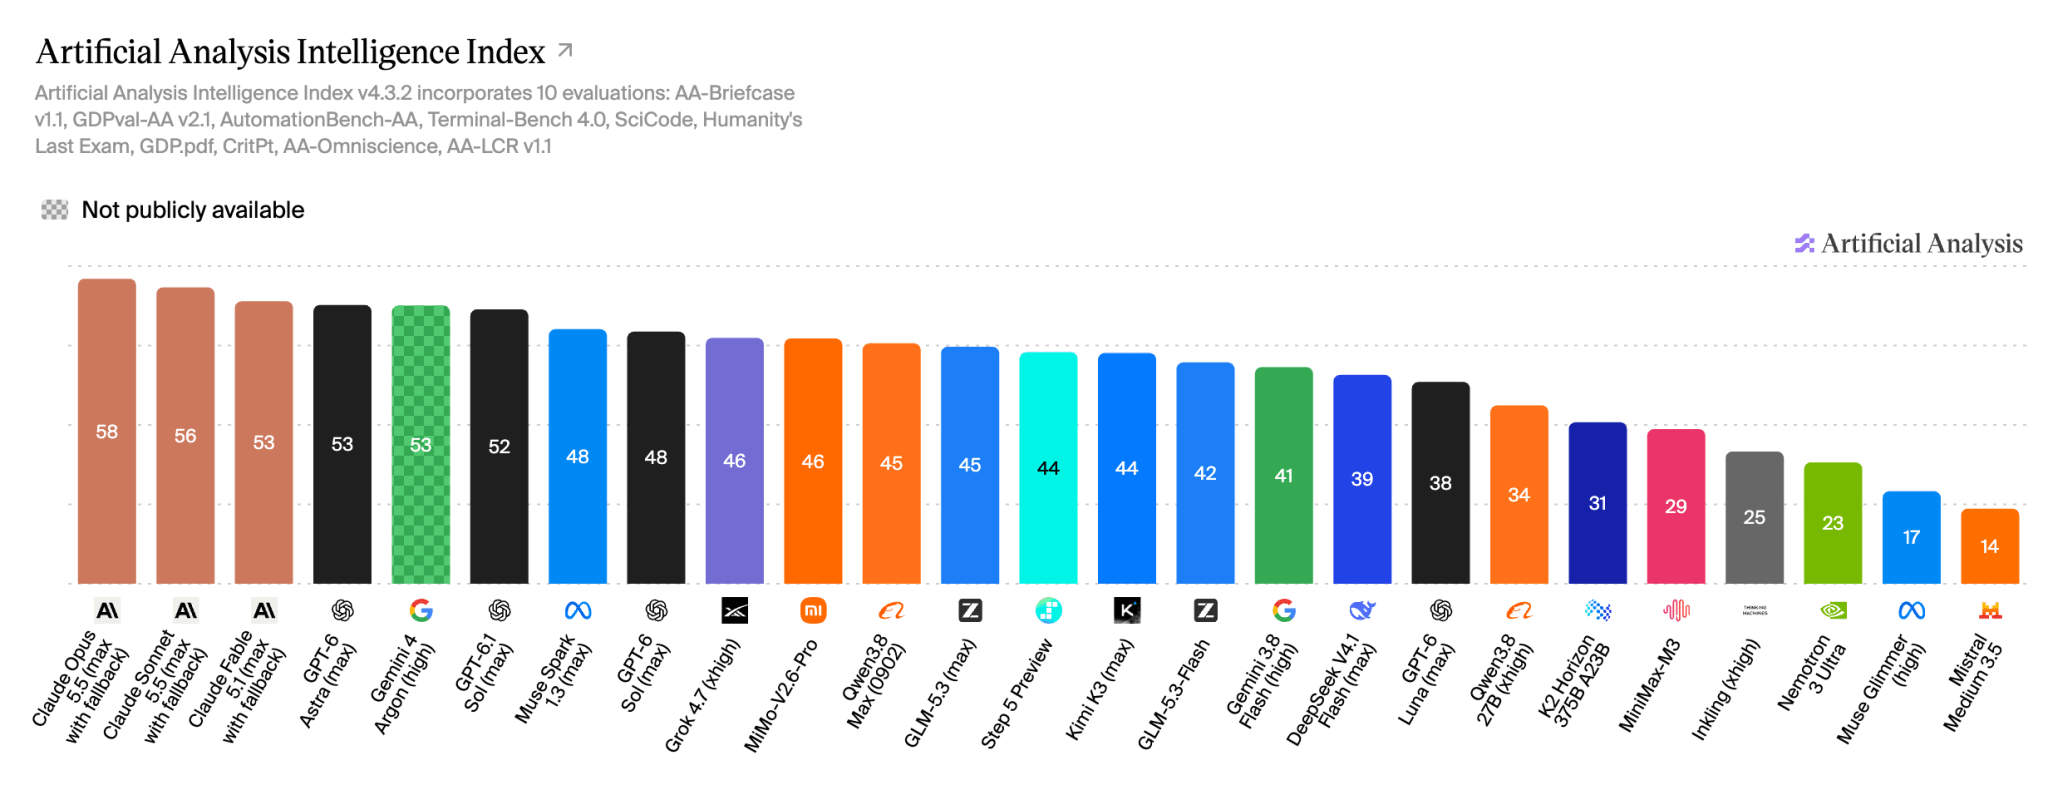
В измерениях Artificial Analysis Argon на высоком reasoning effort набрала 53 балла, столько же, сколько GPT-6 Astra на максимальном. Индекс интеллекта здесь объединяет результаты нескольких тестов на знания, рассуждение и работу агентов. Google вернулась в группу лидеров, но экономику пока держит скидка. Средняя задача этого набора стоит $1.99 против $3.26 у Astra. После удвоения прайса расчётная стоимость Argon вырастет до $3.98. Она в среднем генерирует около 62 тысяч выходных токенов на задачу против 27 тысяч у Astra. Получается, дешёвый токен помогает оплачивать более длинное рассуждение; само рассуждение короче не стало.
Google показывает и внутренние применения Argon. По данным компании, агенты нашли оптимизации, высвободившие больше 300 TiB памяти в дата-центрах. В видеодекодере libgav1 они переписали 32 тысячи строк SIMD-кода, то есть операций над несколькими значениями одновременно, на безопасный Rust с автоматической векторизацией компилятором. Получилось в 2.7 раза быстрее прежнего Rust-порта при том же видео на выходе. Сравнение идёт именно с Rust-портом: до оптимизированного C++ новая версия ещё подтягивается.
У Pi вышла версия 1.0. Если что, это одна из самых популярных harness, которая славится своей кастомизируемостью и легкостью. В стабильную версию добавили Codemode, где агент управляет инструментами через код, нативную поддержку MCP, и их отложенную загрузку. Описания всех доступных инструментов больше не обязательно тащить в каждый запрос. Есть также прогрев кэша Anthropic для повторного использования уже обработанного контекста и возможность добавлять системные сообщения по ходу разговора. Pi сохраняет небольшой базовый набор возможностей, а остальное отдаёт расширениям.
Pi Durable выпустили отдельным экспериментальным пакетом для приложений с агентами. Он сохраняет состояние выполнения на каждом шаге, чтобы процесс можно было остановить и продолжить после перезапуска. Но восстановление различает незаконченный запрос к модели и незаконченный вызов инструмента. Запрос можно послать заново, а инструмент повторяется только при безопасном воспроизведении. Сохранить историю недостаточно, если агент успел отправить письмо, а подтверждение потерялось.
На OpenAI DevDay 29 сентября набралось больше двадцати анонсов. В центре этой пачки оказалась попытка превратить ChatGPT в место постоянной работы: модели, фоновые агенты, общие документы и инструменты разработчиков. GPT-6.1 Sol заменяет GPT-6 Sol, про который я писал в прошлом выпуске, через семь дней после релиза. Цена осталась $2/$10 за миллион токенов, а чтение кэша подешевело с $0.20 до $0.10. Модель доступна через API, Codex и ChatGPT Work; в обычном Chat её на старте ещё нет.
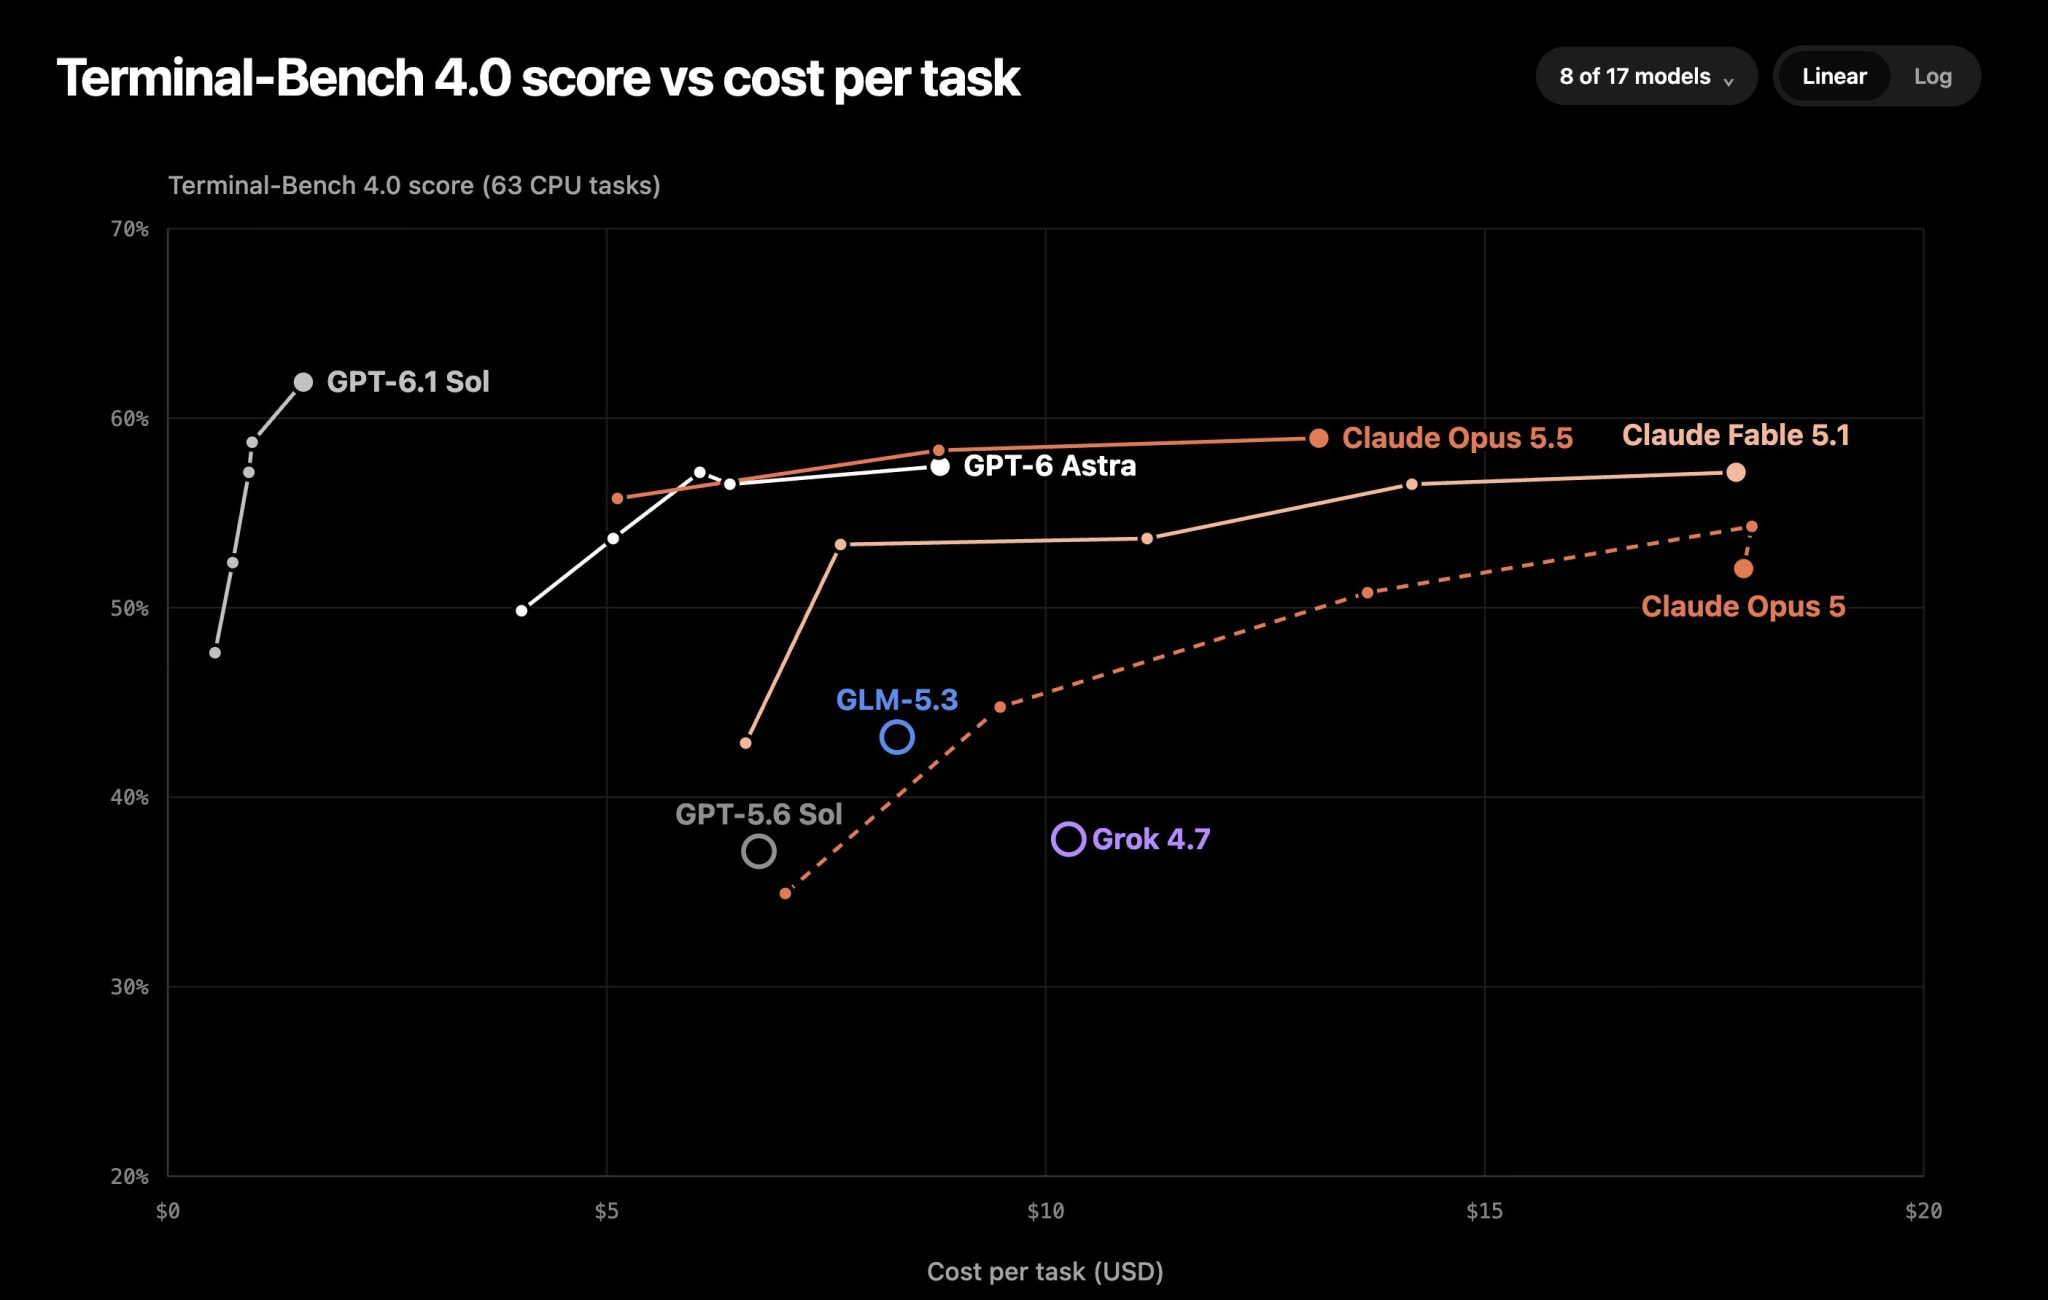
Обещание "почти Astra за пятую часть цены токена" проверили Artificial Analysis. На максимальном усилии Sol отстаёт от Astra на один балл в индексе интеллекта, а средняя задача стоит $0.72 против $3.26. Относительно предыдущего Sol стоимость задачи снизилась на 31%, хотя выходных токенов новая модель использует больше. Эффективность складывается из качества ответа и цены всего прогона, поэтому одинаковый прайс за миллион токенов ещё не означает одинаковый счёт.
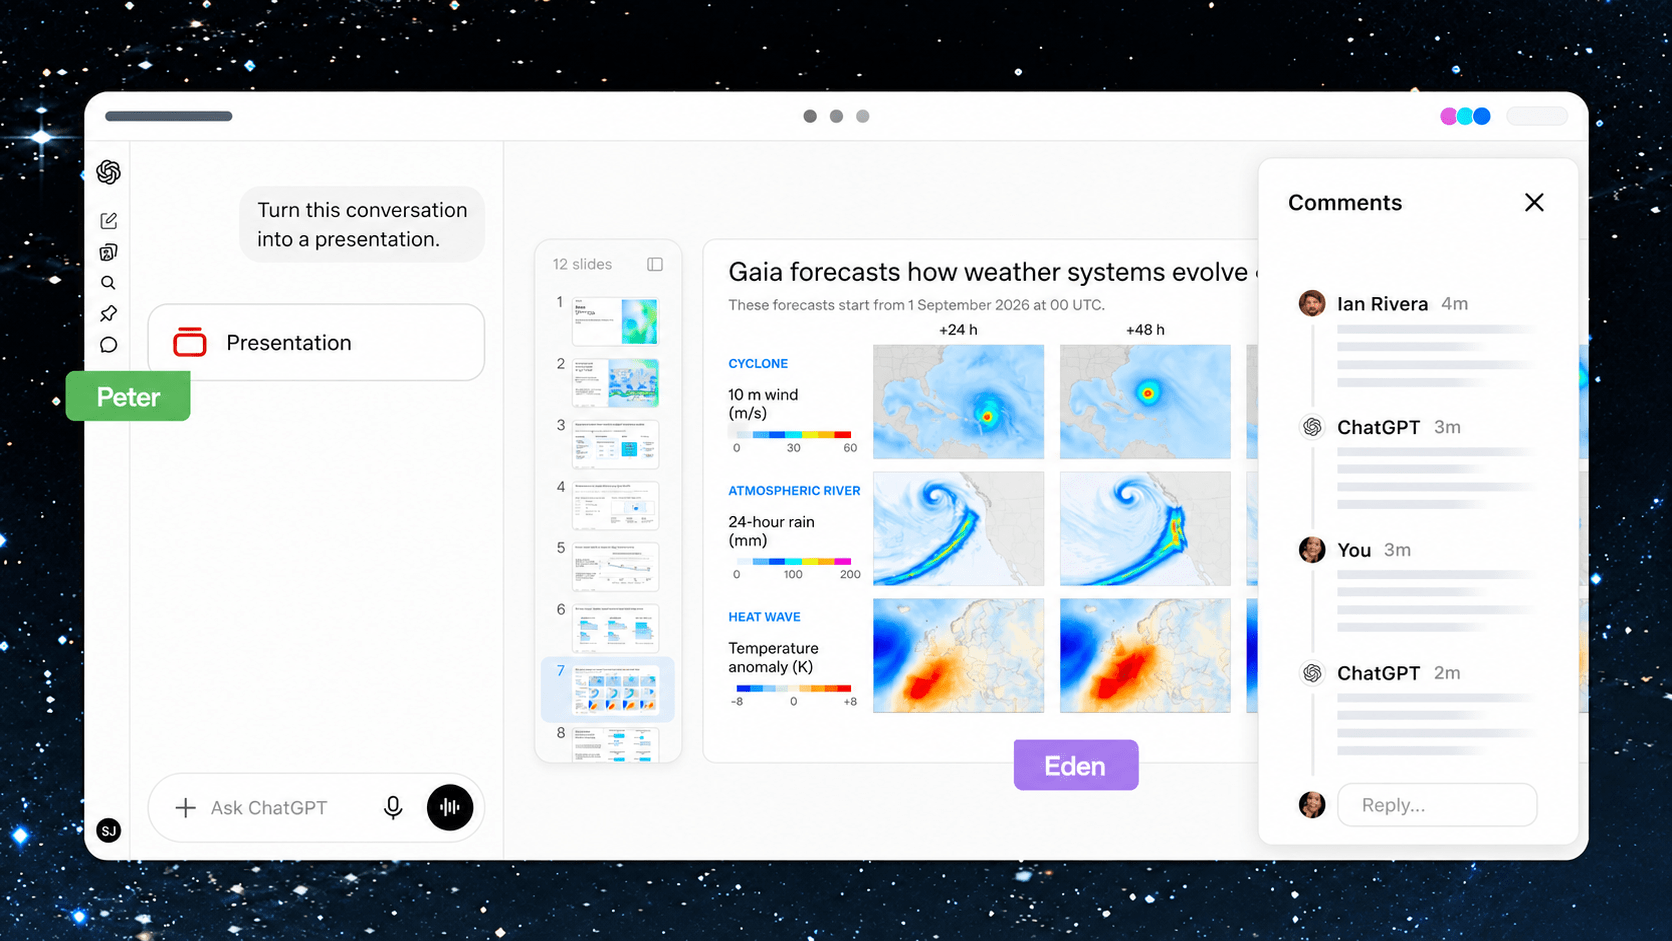
Dots получили собственный облачный компьютер и постоянные задачи. Такой агент может следить за подключёнными источниками, разбирать обратную связь, готовить правки и приносить результат на проверку. Фоновое самостоятельное исследование ограничено чтением: отправлять сообщения и менять данные в этом режиме нельзя. Задания, которые вы ему поручили, выполняются по правилам доступа и согласований. Dots постепенно появляются на Pro и Business Premium в поддерживаемых странах, а корпоративным пользователям доступна бета с включением администратором. Разговоры с dot не расходуют лимит ChatGPT, но запущенная им работа в Codex или ChatGPT Work расходует обычную квоту.
Для результатов этой работы есть ChatGPT Space, общее пространство команды, и Pages, документы для совместного редактирования людьми и агентами. Совместные презентации пока обещаны в ближайшие недели. Codex получил облачные окружения, голосовой ввод в консольном клиенте и управление несколькими агентами; Agents API теперь умеет работать с компьютером. Разработчикам открыли расширения интерфейса ChatGPT через плагины. Через Sign in with ChatGPT включённый в подписку объём можно расходовать и в участвующих сторонних инструментах. Ещё появился корпоративный Marketplace, где часть обязательств по оплате OpenAI можно направить на одобренное партнёрское ПО.
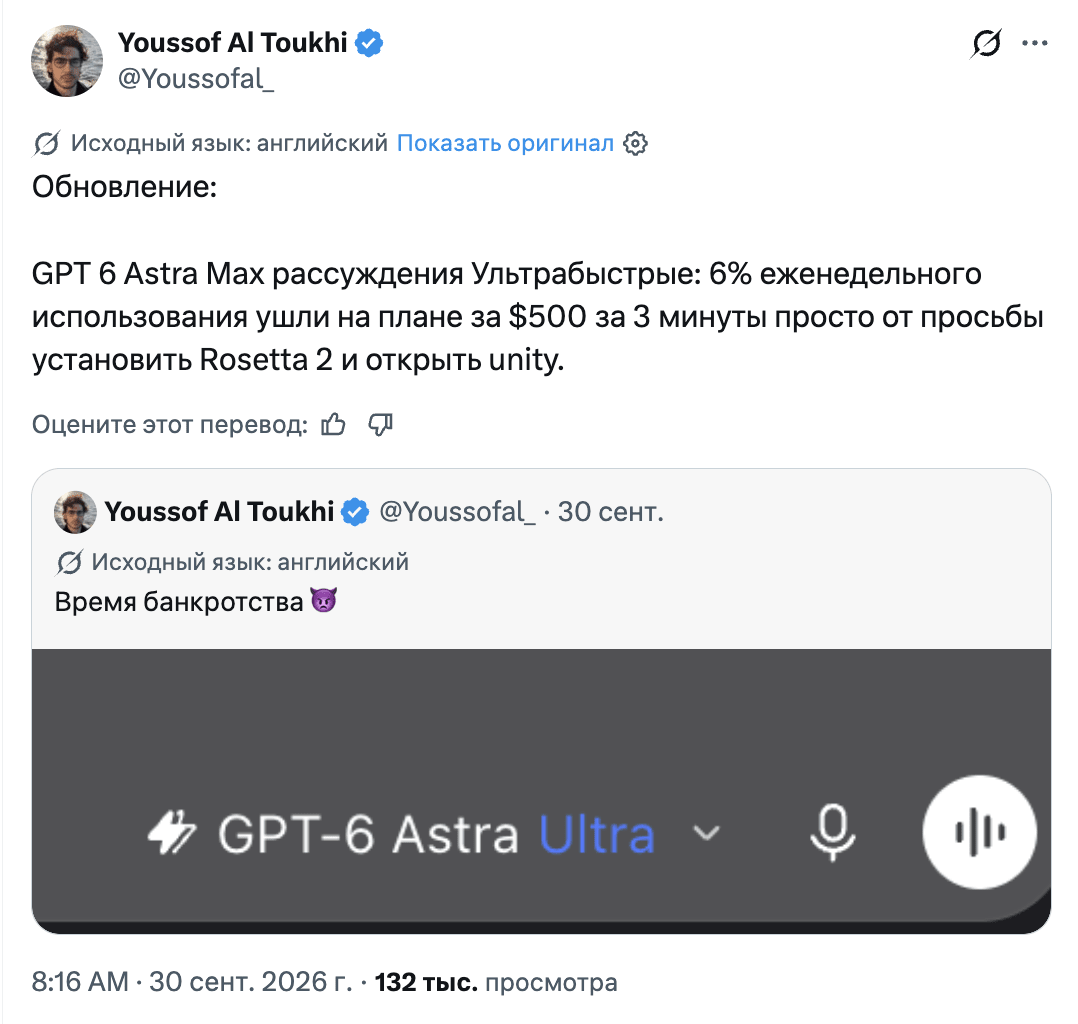
Новый тир подписки ChatGPT Pro 500 стоит $500 в месяц. Pro 200 остаётся по $200 с меньшим включённым объёмом. По пояснению Тибо, руководителя Codex в OpenAI, Plus служит базой 1x, Pro 100 даёт 5x, новый Pro 200 даёт 10x вместо прежних 20x. У Pro 500 заявлено 25x. Это относительные квоты.
Прежнюю квоту сохраняют по 29 октября 2026 года включительно те, у кого Pro 200 была активна хотя бы в какой-то момент между 22 сентября и 29 сентября, 10:00 по тихоокеанскому времени. Для использования старого объёма подписка должна быть активна; подходящая повторная подписка на том же аккаунте тоже учитывается. После 29 октября объём снизится при прежней цене $200.
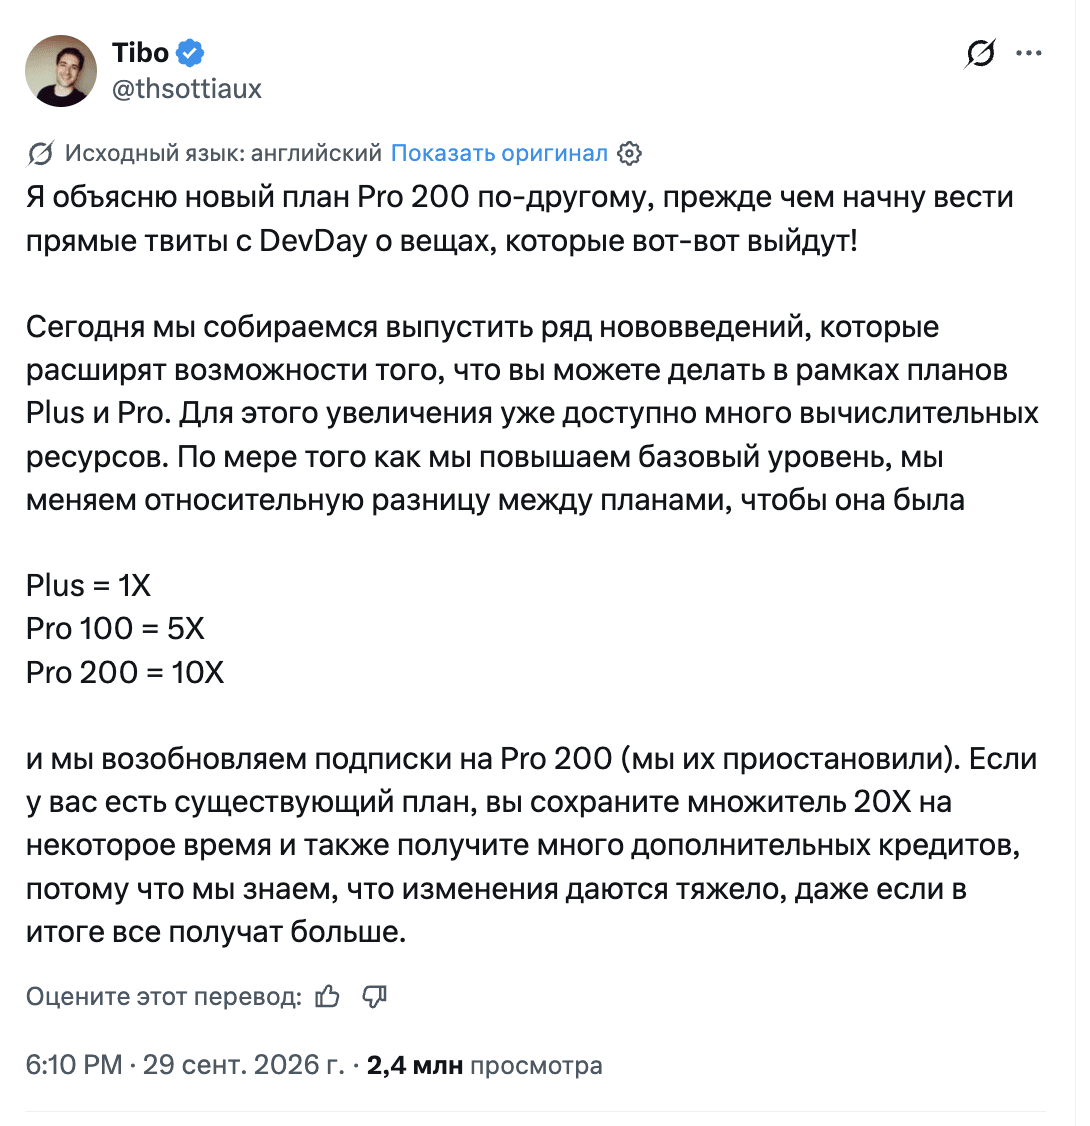
Тибо объяснил изменение эффективностью новых моделей. Эквивалент включённого API-расхода уменьшается вдвое, но компания обещает со временем больше выполненной работы за те же деньги. В ответах ему досталось. Есть упрёки в ухудшении сделки, заявления об уходе к Claude, сарказм по поводу обещания больше работать с половинной квотой и персональные выпады. Люди уже встроили щедрую подписную квоту в свою работу, и обещание будущей эффективности плохо компенсирует конкретное сокращение сегодняшнего объёма. Включённые в подписку токены могли ощущаться бесплатными после ежемесячного платежа. После сокращения квот Claude Code, которое разбирали две недели назад, OpenAI сокращает включённый объём своей вместительной подписки. Мне такой обмен не кажется подарком. За старые 20x платили $200, за новые 25x предлагают $500: цена выросла в 2.5 раза относительно прежнего плана, номинальный объём вырос на четверть. У дорогого тарифа есть дополнительные возможности, но для человека, который покупал прежде всего вместительную квоту, арифметика неприятная. Я читаю это как ужесточение монетизации интенсивной работы. Объяснение OpenAI про более эффективные модели может быть верным одновременно с тем, что прежняя сделка для активного пользователя становится хуже.
Дополнительная возможность Pro 500 — Astra Ultrafast, режим ускоренной генерации. На DevDay OpenAI обещала до восьми раз быстрее в Codex и до шести в API; Sol Ultrafast пока объявлен на будущее. В подписке Astra Ultrafast расходует включённый объём в восемь раз быстрее Standard той же модели. Покупка дополнительных кредитов на Pro 100 или Pro 200 режим не открывает.
Anthropic выпустила Claude Sonnet 5.5 с прежними $2/$10 за миллион токенов и $0.20 за чтение кэша. Компания заявляет генерацию более чем на 30% быстрее Sonnet 5 и меньший расход токенов на задачу. В прогоне Artificial Analysis на максимальном усилии картина другая. Sonnet набрала 56 баллов в индексе интеллекта против 58 у Opus 5.5, но использовала около 193 тысяч выходных токенов на задачу. Это самый высокий расход в их измерениях, примерно в семь раз больше Astra на максимальном усилии. Средняя задача стоила $7.60, примерно на 50% дороже прежнего Sonnet.
Эти результаты относятся к предрелизной версии, в которой позже исправили дефект структурированных ответов; AA обещает повторную оценку. Они всё равно хорошо показывают, почему "Sonnet дешевле Opus" нельзя проверять одним прайс-листом. Настройка усилия определяет, сколько модель будет рассуждать и перепроверять себя. В Claude Code и приложениях по умолчанию стоит Medium, на платформе High, а рекордные цифры обсуждаются для Max. У AA именно High оказался наиболее конкурентным по соотношению качества и стоимости.
У моделей решений, о которых я писал в выпуске про Jev и его первые альтернативы, появились новые поставщики. Задаются разрешённые ответы, а модель возвращает выбор или вероятности вместо свободного текста, который потом надо разбирать кодом. На DevDay OpenAI показала Decisions API на базе Luna для текста и изображений; пока это ограниченный предварительный доступ. Для маршрутизации запроса между агентами или классификации обращения такой отдельный шаг может заменить длинный разговор с универсальной моделью.
Cloudflare выпустила Clef и Clef-flash с открытыми весами под Apache 2.0 и размещением на Workers AI. Они совместимы с API Jev, понимают изображения и принимают до 64 тысяч токенов контекста. В собственных сравнениях Cloudflare модели обходят Jev на нескольких наборах, но не на каждом тесте. Появление общих таблиц уже полезно. Раньше альтернативы в основном соревновались на собственных примерах.
Perplexity добавила Decisions API с моделью pplx-decider-v1-27b. Цена составляет $0.04 за миллион входных токенов, выход бесплатный. Это дообученная Qwen3.8-27B с открытыми весами под Apache 2.0, поддержкой изображений и заявленным контекстом 250 тысяч токенов. В карточке модели опубликована средняя точность 85.71% на одиннадцати тестах против 84.51% у Jev. На сложной публичной части JevBench, наборе задач выбора структурированных решений, Perplexity уступает: 70.30% против 73.27%. Общий средний результат поэтому не обещает победу на ваших данных. Зато теперь можно выбирать между облачным API и запуском тех же весов у себя, а не привязывать весь шаг принятия решений к одному сервису.
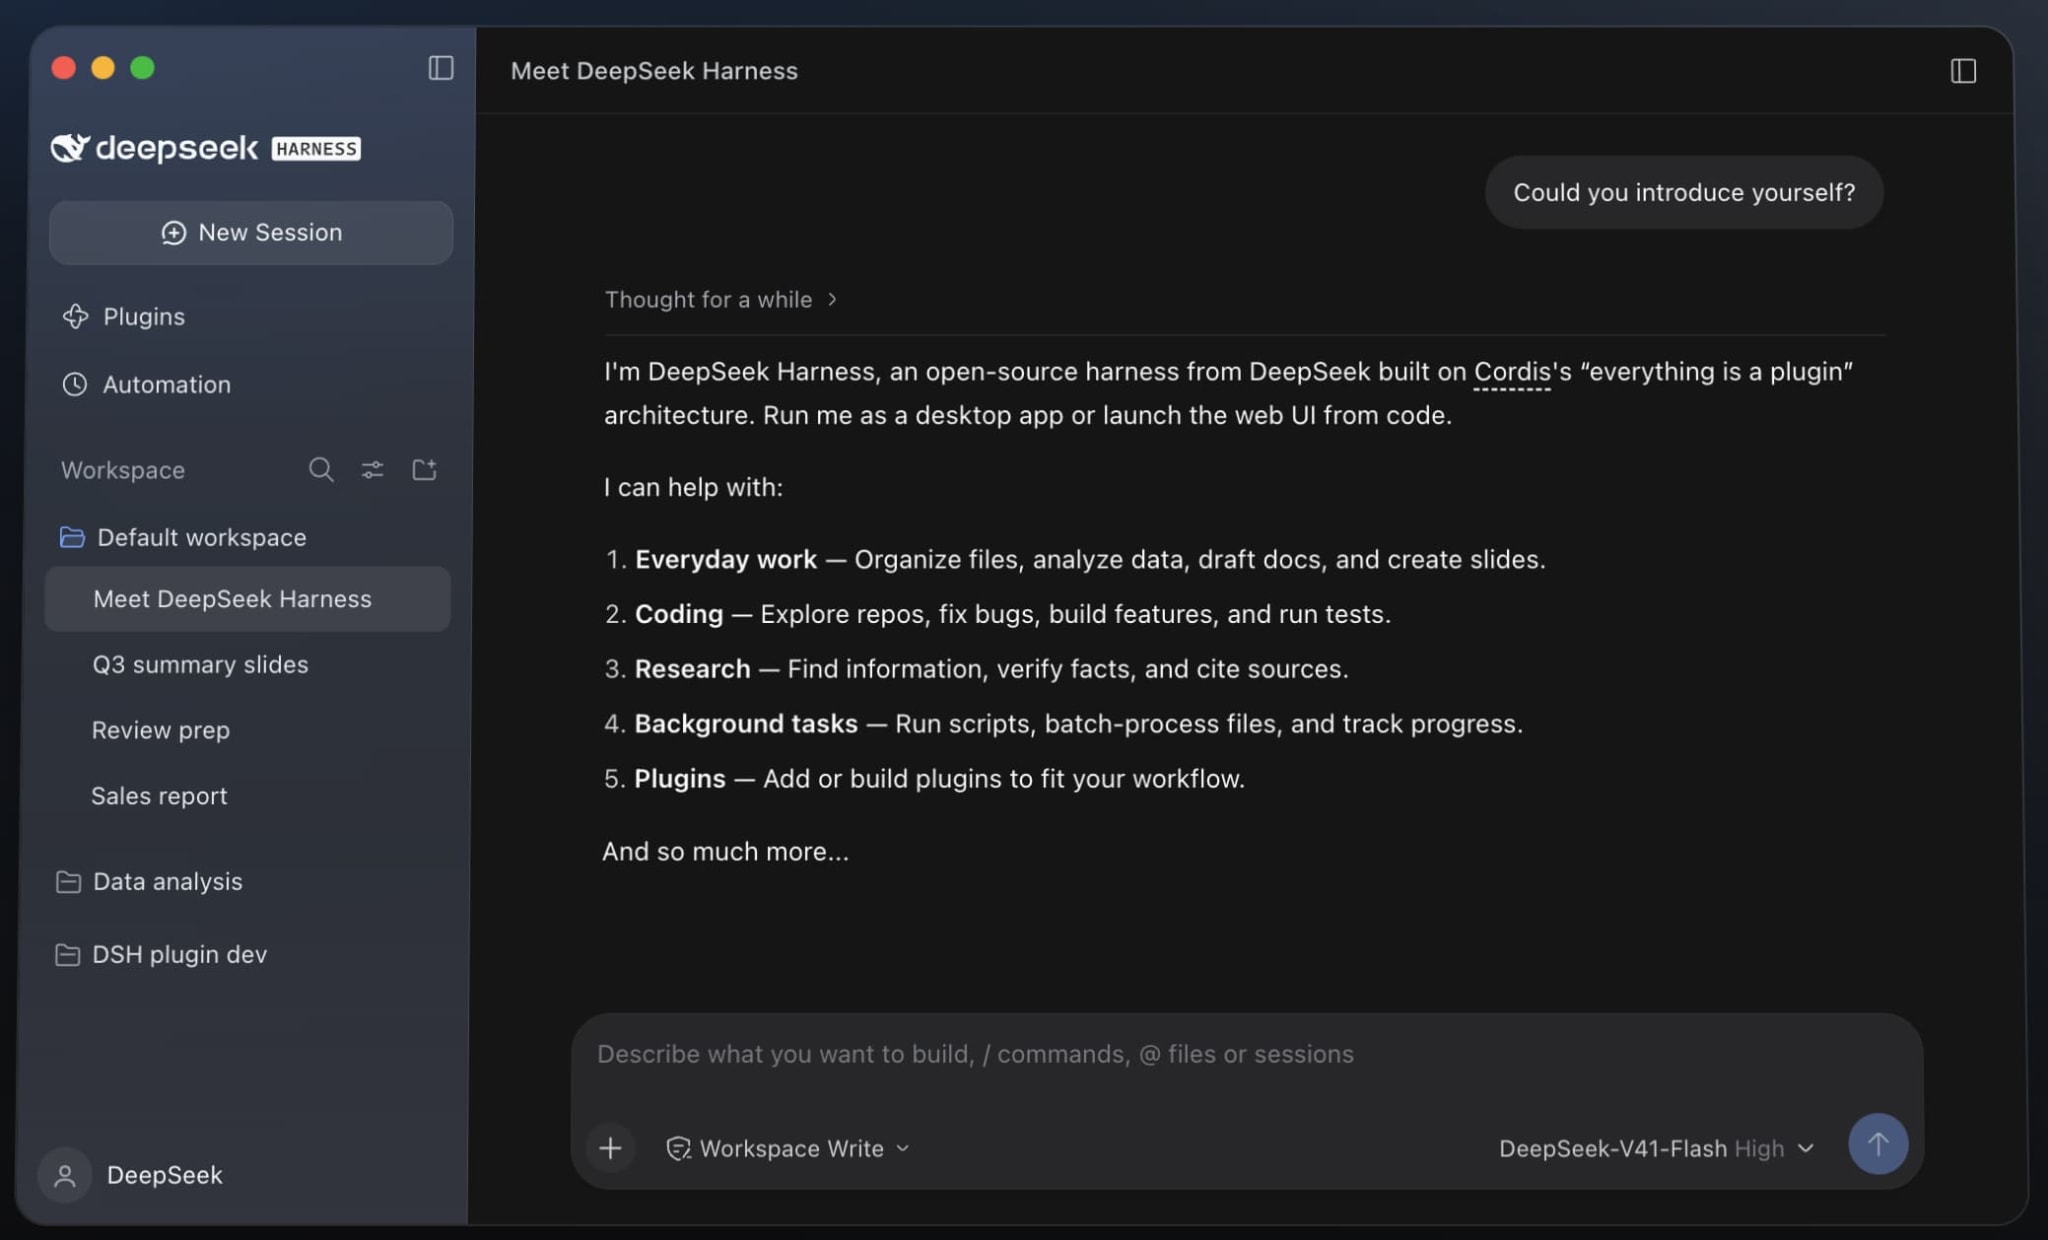
DeepSeek показала Harness, открытую под MIT оболочку на архитектуре Cordis. Она работает с кодом, файлами, таблицами, документами и фоновыми заданиями; есть приложение для macOS на Apple Silicon и Windows, а веб-интерфейс запускается через Node.js. Инструменты, поведение агента и интерфейс расширяются плагинами. В режиме Creator агент может написать новый плагин по описанию. Это пока публичная предварительная версия, а команды агентов, расписания и автоматическая проверка согласований помечены экспериментальными. При таком подходе расширение может добавить и действие, и способ показать его результат в том же приложении: таймер, панель данных или просмотр созданного документа.
Исследователи Meta Superintelligence Labs вместе с коллегами из Вашингтонского университета, MIT и Trillium Labs предложили Context Language Models. Это способ управления контекстом существующих моделей, а не новый самостоятельный чатбот. История, которую модель видит на следующем шаге, становится редактируемым файлом. Агент может удалить ненужные фрагменты, обновить таблицу состояния или сохранить важные факты в компактной записи; изменения синхронизируются с его живым контекстом. Для нескольких агентов можно вести несколько таких файлов.
На EdgeBench, десяти задачах длительной оптимизации программ, такой подход за двенадцать часов дал результат на 5% выше базового метода, использовав на 59% меньше вычислительных операций. Отдельно авторы доработали повторное использование кэша: после правки истории сохраняют вычисления для уцелевших фрагментов, включая часть после изменённого места. Обычный кэш переиспользует только совпадающее начало.
Anthropic добавила Mods в Claude Code. После поддержки AGENTS.md и облачных Projects появляется возможность менять поведение самого клиента. Мод представляет собой небольшую функцию TypeScript внутри плагина и работает в CLI или приложении. Она может перехватить событие до выполнения, после него или вместо него. Например, переписать запрос к модели, заблокировать вызов инструмента, убрать секрет из результата или заменить элемент интерфейса. Встроенный /diff уже стал модом, который можно отключить или заменить своей реализацией.
Для команды это даёт место под собственные правила и панели: статус сборки рядом с разговором, журнал вызовов, дополнительное согласование перед изменением продакшен-конфига. Несколько модов обрабатывают событие в порядке загрузки, поэтому порядок тоже влияет на результат. В управляемых установках встроенный sec-default загружается первым и ограничивает опасные переопределения пользовательскими модами. При этом сами моды не изолированы в песочнице и получают тот же доступ к машине, что Claude Code. Установленный мод становится частью инструмента, которому вы доверили проект и рабочее окружение.
На прошлой неделе мы запустили исследование "ИИ на работе: экономия времени или новая нагрузка?". Хотим понять, сколько времени ИИ экономит на реальных рабочих задачах с учётом подготовки запросов, проверки и переделок, что происходит с качеством и нагрузкой на сотрудников. Мы уже получили хорошие данные, и ваши ответы помогут сделать результаты точнее.
Если вы сейчас работаете в России или за рубежом и ещё не участвовали, заполните анкету. Даже если вы не используете ИИ в работе, ваш опыт нам тоже важен. Анкета займёт около 10 минут, всё анонимно. Результаты опубликуем в обобщённом виде в конце октября.
Оставайтесь любопытными.
Пишу об искусственном интеллекте, языковых моделях и инструментах для разработчиков. Тестирую модели и сервисы на реальных задачах, а выводами делюсь в телеграм-канале.