Галлюцинации недели: Mistral Large 4, Claude Haiku 5.5 и переход Deno в Cloudflare
OpenAI за неделю трижды сбросила пользователям лимиты, а Anthropic в это время вписала в правила защиту Claude от пользователей. С 12 ноября на Opus можно ругаться, но нельзя его травить.
OpenAI выложила на GitHub больше семисот математических рукописей, которые написала её внутренняя модель. Саму модель не выпустили. По словам компании, за время оценки модели дали около 4000 открытых задач, и в среднем на один результат уходило примерно три часа вычислений в пересчёте на размышления ChatGPT Pro. О формате публикации OpenAI советовалась с независимой консультативной группой по математике и ИИ при Институте перспективных исследований.
Сейчас в репозитории 719 рукописей в 372 семействах результатов. Изначально их было 722, но уже 7 октября три работы про гипотезу Ходжа и классы Вейля отозвали: ошибка в знаке ломала аргумент в одной статье и в двух, которые на неё опирались. Ещё 14 рукописей исправили. Формальные доказательства на Lean, языке, в котором компьютер проверяет каждый шаг рассуждения, есть для 300 главных результатов из 719, это около 42%. Про остальные OpenAI предупреждает, что в них могут быть проблемы.
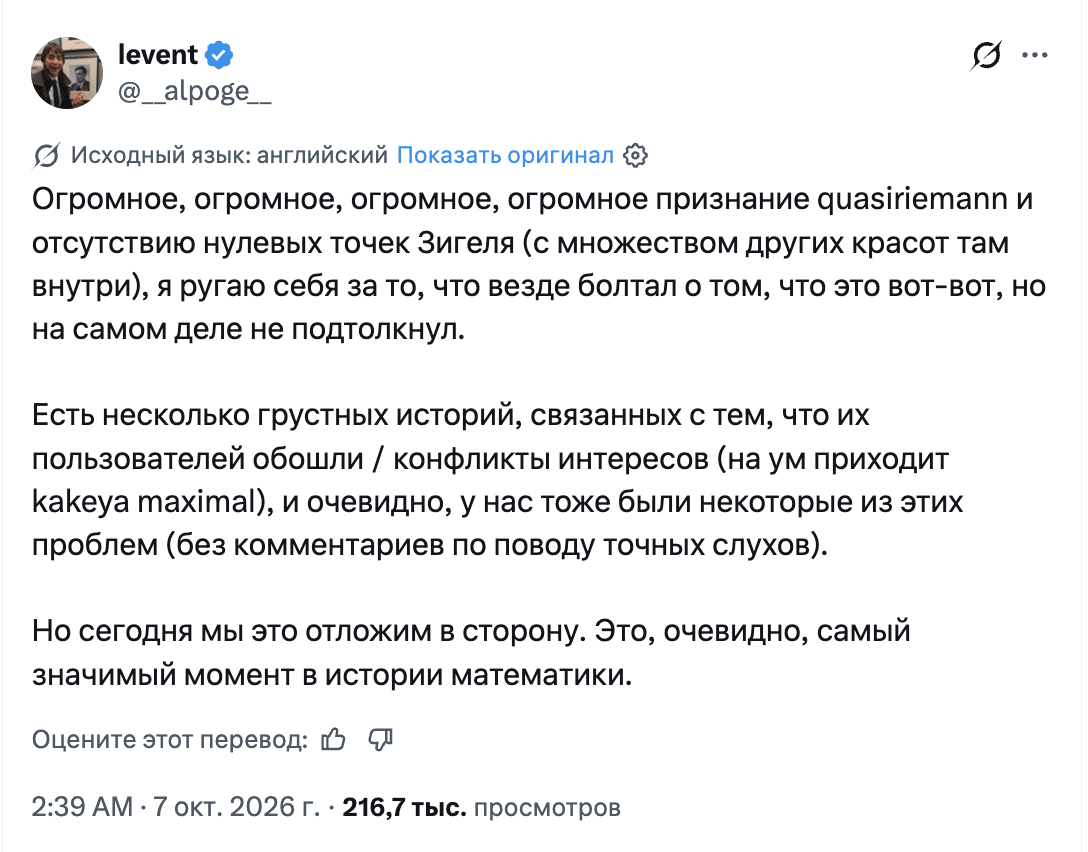
Среди результатов есть квази-гипотеза Римана. Её особо отметил Левент Альпёге, математик из Anthropic, то есть из конкурирующей лаборатории, и назвал релиз очевидно самым значимым моментом в истории математики. В том же посте он упомянул истории, когда людей опережали в их же задачах, и конфликты интересов, но предложил на сегодня это отложить. На мой взгляд, узким местом теперь становится проверка. Компьютер подтвердил меньше половины главных результатов, остальное придётся читать живым математикам, и первые три работы отозвали на следующий день после публикации.
Mistral показала Mistral Large 4 в публичном предварительном доступе через API. Это MoE на 1 трлн параметров: на каждый токен включается только часть сети, здесь 52 млрд параметров. Модель мультимодальная, по документации у неё контекст 1 млн токенов. Цена $1.36/$4.18, первые две недели действует скидка 50%. Открытые веса обещают к концу октября, лицензию пока не назвали. Обучали модель на 3800 GPU Grace Blackwell в собственных европейских дата-центрах Mistral, и RL-обучение, по словам компании, ещё продолжается.
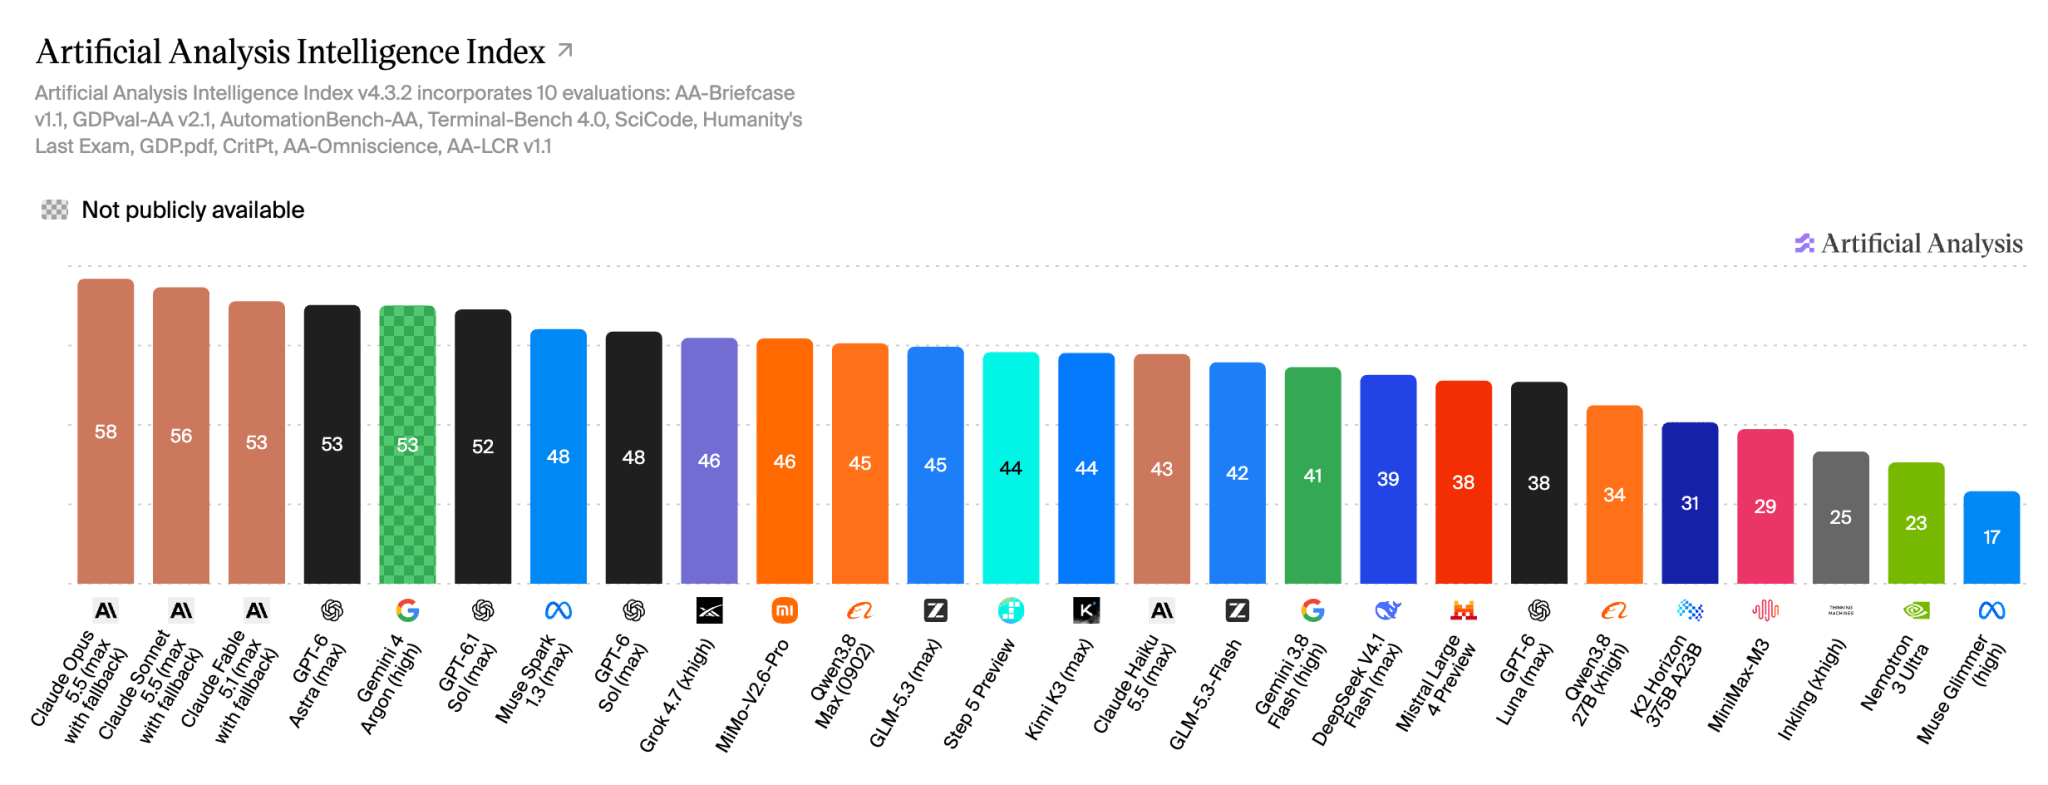
Artificial Analysis дала модели 38 баллов индекса интеллекта, сводной оценки по тестам на знания, рассуждение, код и агентную работу. Столько же у GPT-6 Luna на максимальном усилии, у DeepSeek V4.1 Flash 39. Среди моделей не из США и Китая у Mistral Large 4 лучший результат. Но одна задача индекса обходится в $1.13, а у GLM-5.3 Flash в $0.25. Сама Mistral приводит слепую человеческую оценку кода: 3.74 против 3.60 у GLM-5.3 и 3.59 у Kimi K3, при 4.22 у Claude Opus 5. Цифры пока гуляют. Artificial Analysis пишет про 49 млрд активных параметров и 512 тысяч токенов контекста, Mistral про 52 млрд и миллион. Для Европы заявка сильная, и наконец над Mistral перестанут смеяться, но пока весов нет, это ещё один платный API.
Anthropic выпустила Claude Haiku 5.5, первое обновление младшей модели почти за год. Цена $0.10/$0.50 для запросов до 100 тысяч токенов, ровно как у GPT-6 Luna. Выше порога всё дорожает впятеро, до $0.50/$2.50. Контекст вырос до миллиона токенов, и впервые у Haiku есть настройка reasoning effort от Low до Max. Anthropic видит в ней субагента при Opus 5.5 или Sonnet 5.5: сжатие контекста, пересказы, классификация, запросы к базе.
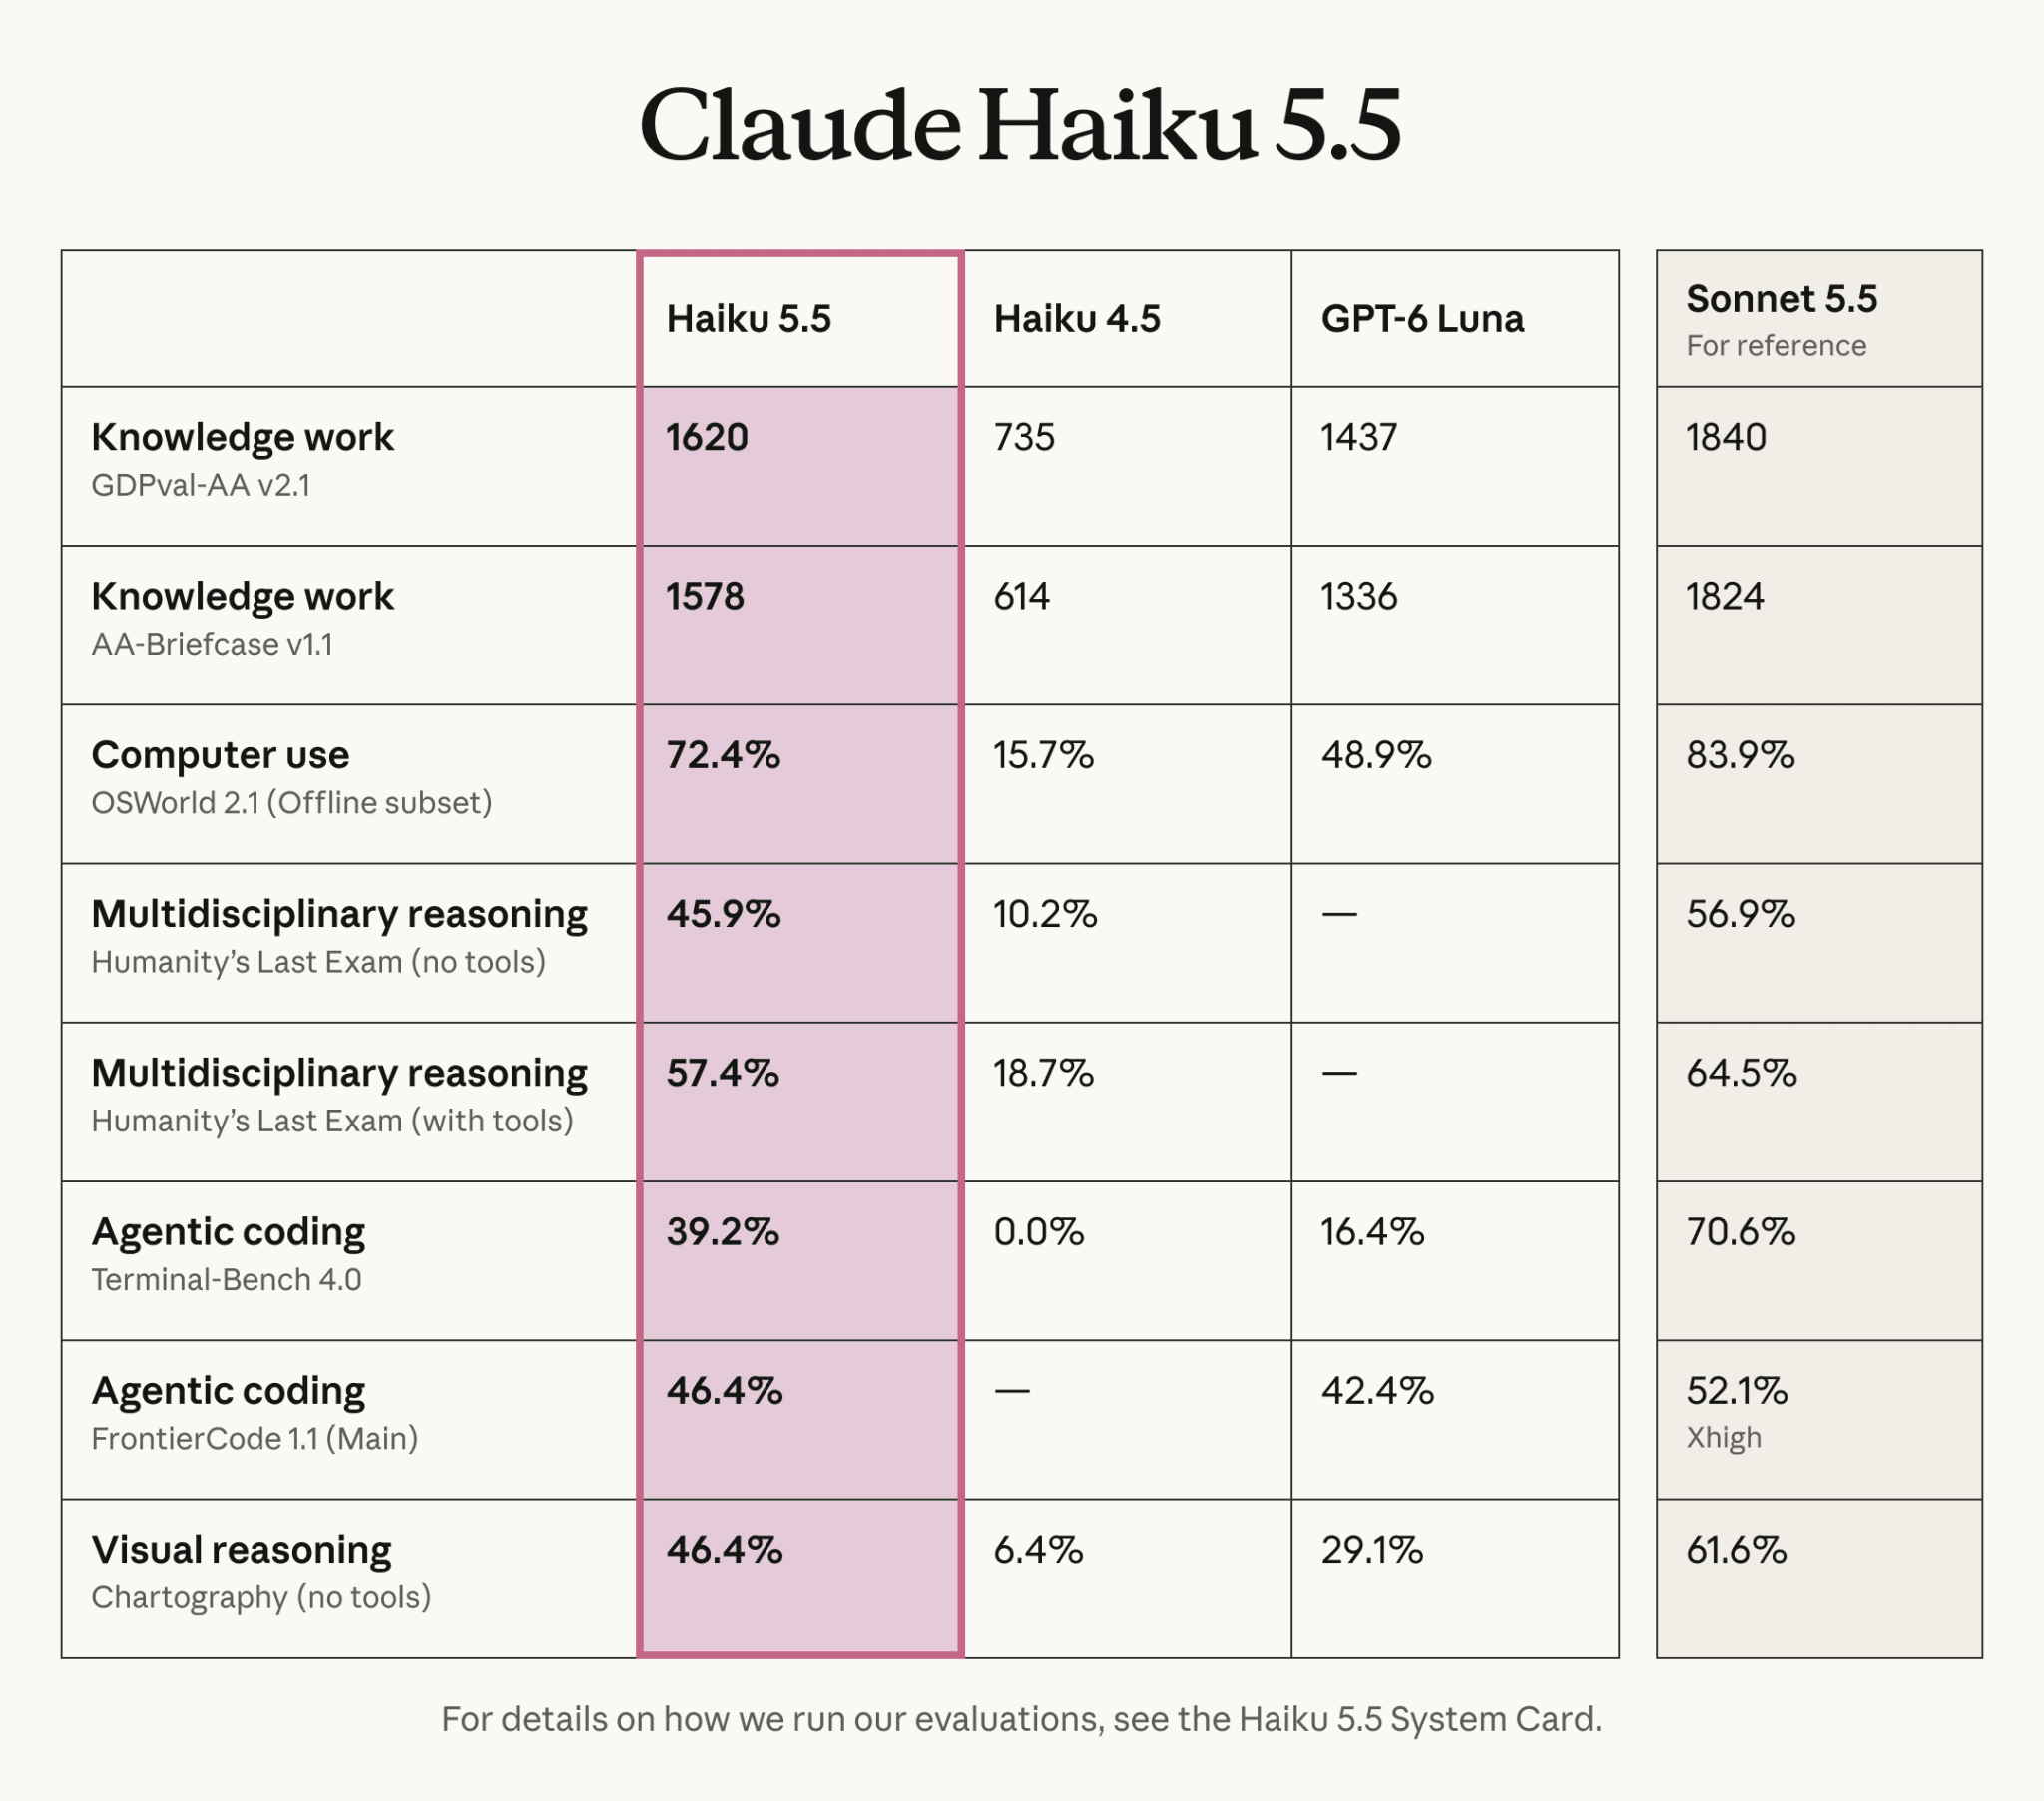
По измерениям Artificial Analysis на максимальном усилии Haiku набирает 43 балла индекса, чуть выше GLM-5.3 Flash (42), Gemini 3.8 Flash (41) и Luna (38). На Terminal-Bench 4.0, где агент решает многошаговые задачи в терминале, у неё 33% против нуля у Haiku 4.5. В тесте знаний AA-Omniscience модель отвечает верно реже конкурентов, 36% против 44% у Luna, зато реже выдумывает, когда не знает ответа: доля галлюцинаций 40% против 77%.
На максимуме Haiku тратит около 162 тысяч выходных токенов на задачу индекса, втрое больше Luna. В Vals AI посчитали, что в большинстве запросов по юридическому поиску контекст переваливает за 100 тысяч токенов, где цена впятеро выше. В итоге тест на Haiku 5.5 обходится дороже, чем на Haiku 4.5, на всех бенчмарках, где сравнивали обе модели. Anthropic при этом обещает, что в среднем новая модель на 75% дешевле прошлой версии. Короткие запросы действительно стоят копейки, а за длинные агентные прогоны придётся платить.
OpenAI выкатила GPT-6 в обычный чат ChatGPT вместе с Intelligent UI. Платные тарифы получают GPT-6 Sol, Free и Go получают Luna, а модели режима Work и Codex не менялись. Ответ теперь собирается не только из текста, но и из графиков, кнопок, форм и маленьких калькуляторов. В демо план воскресного ужина приходит со счётчиком гостей, который пересчитывает список покупок. Под капотом библиотека нативных компонентов и компилятор, который рисует интерфейс по мере генерации. Модель отдельно учили решать, когда интерактивность нужна, а когда хватит текста. Ещё GPT-6 умеет начинать ответ, продолжая думать: по внутреннему тесту OpenAI на очень высоком усилии она начинает писать так же быстро, как GPT-5.6 на среднем.
На следующий день команда Thesys, которая делает открытый OpenUI, разобрала устройство Intelligent UI по трафику своих аккаунтов и публично доступному JavaScript. Модель пишет смесь Markdown, JSX-подобных тегов и JavaScript, сервер компилирует её в программу, а браузер исполняет программу в песочнице. В каталоге около 70 компонентов. Генеративный интерфейс открытые проекты пробуют давно, но OpenAI выдаёт его аудитории больше чем в 1.2 млрд человек в неделю.
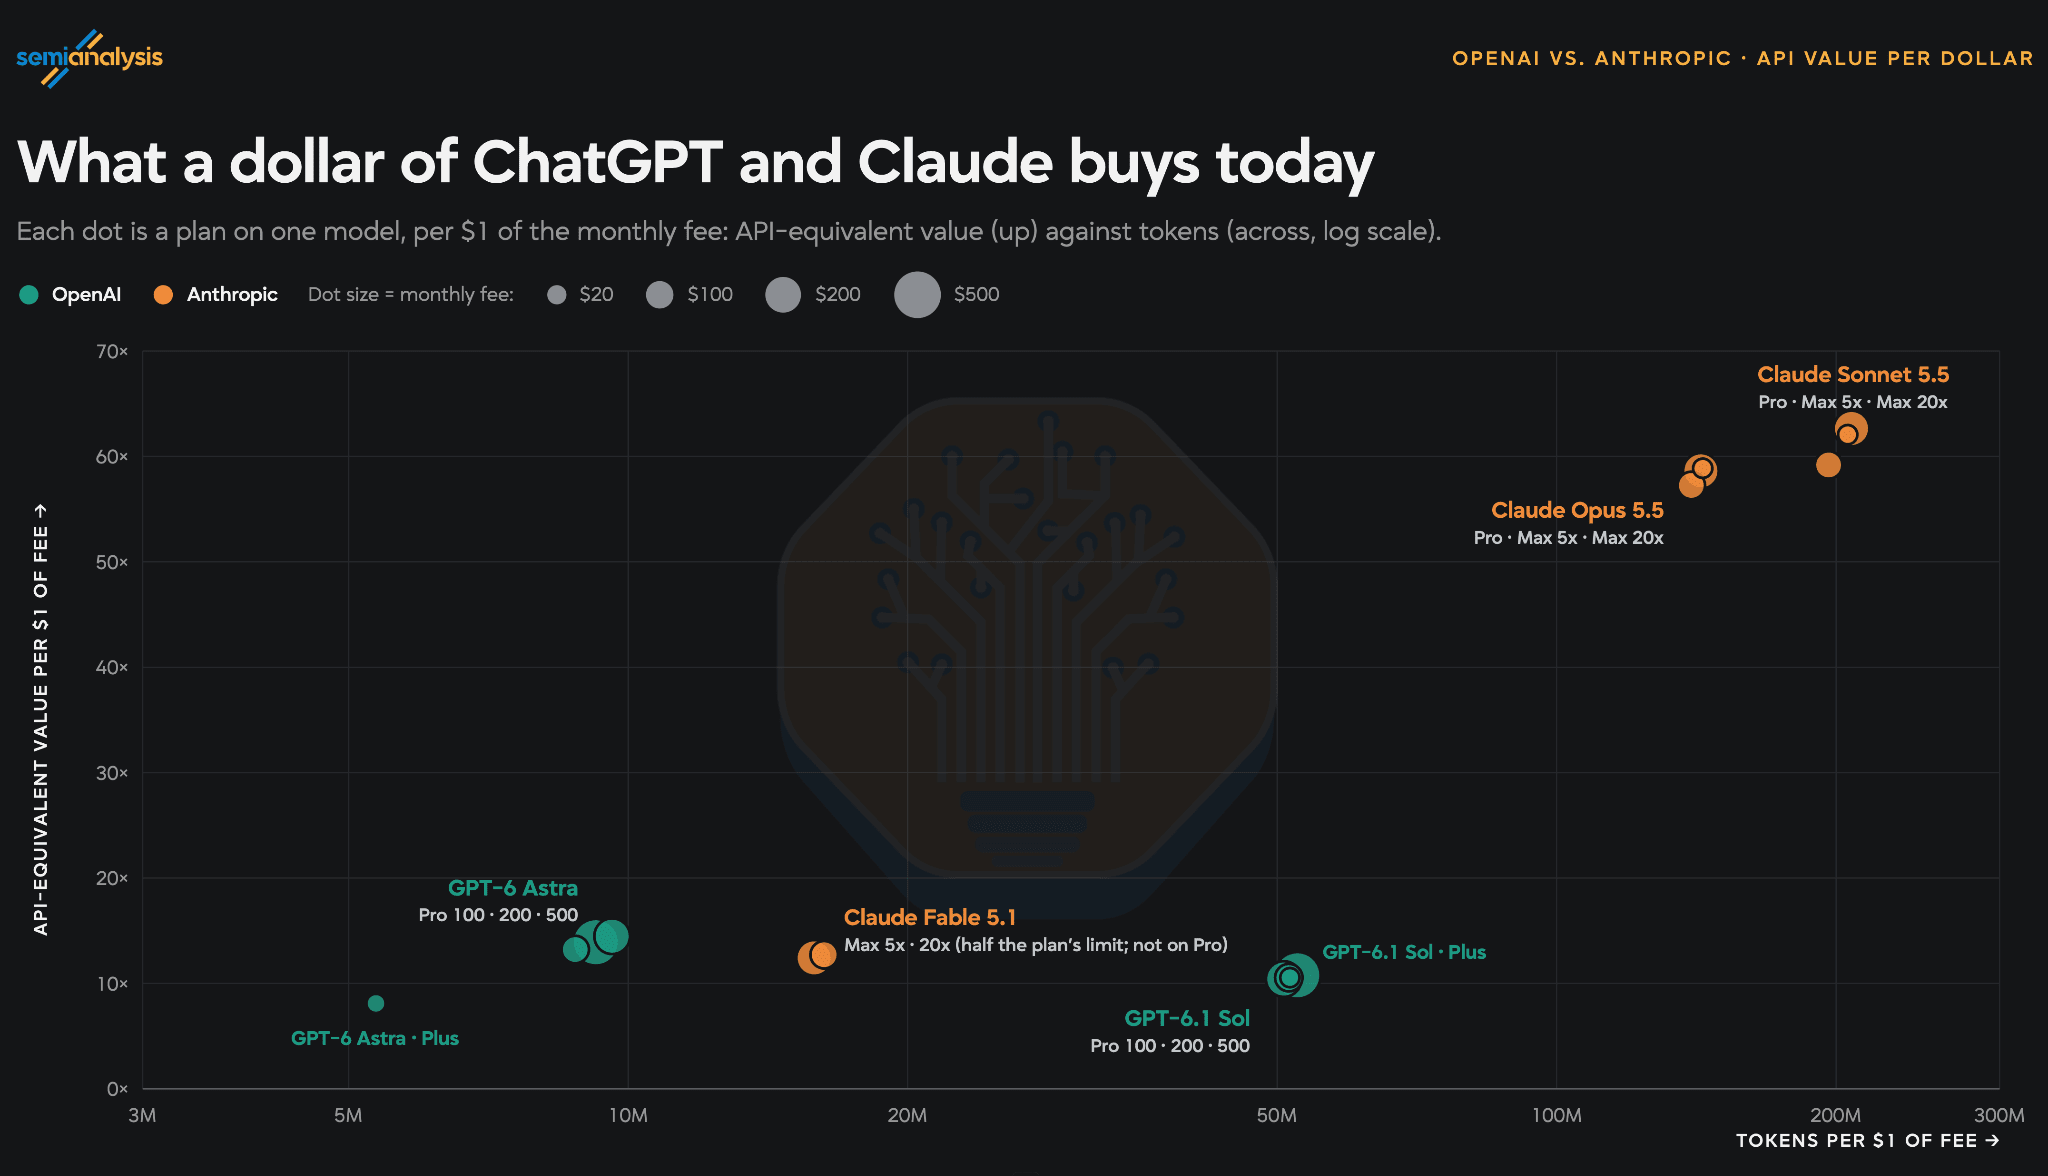
Аналитики SemiAnalysis проверили, сколько API на самом деле помещается в подписки. Они отдельно гоняли входные, кешированные и выходные токены, смотрели, насколько сдвигается счётчик лимита, и пересчитывали результат по ценам API для агентной нагрузки. Вывод вынесен в заголовок: подписки Anthropic дают в пять с лишним раз больше ценности, чем OpenAI. Новый тариф OpenAI за $500, про который я писал на прошлой неделе, по их замерам даёт лишь на 21% больше лимита на GPT-6 Astra, чем старый тариф за $200. Авторы предупреждают, что лимиты меняют без объявлений. У одного из трёх одинаковых аккаунтов они оказались примерно на 20% ниже, и этот поставщик, которого авторы не называют, подтвердил небольшой A/B-тест.
Тибо, руководитель Codex, пообещал 28 дней подряд каждый день выпускать заметное улучшение для пользователей Codex и Work или полностью сбрасывать лимиты. В первый день стандартную скорость GPT-6 Astra и GPT-6.1 Sol по подписке подняли с 30 до 50 токенов в секунду. Ускорение распространили и на партнёров со входом через ChatGPT, включая OpenCode, Pi, Amp и Devin.
На второй день вышло четыре обновления. В их числе режим автоодобрения действий в Codex перестал расходовать лимит. Тибо спросил, удался ли день или нужен сброс, и 57 тысяч против 18 выбрали сброс. Он признал, что игра, похоже, подстроена в пользу сброса, и лимиты обнулили. На третий день по случаю GPT-6 в чате и рекорда в 40 млн активных пользователей Codex и Work дали ещё один сброс, а шестой день целиком состоял из сброса. Итого за неделю три сброса из семи дней.
Настоящих улучшений тоже набралось. В ночь после третьего дня облачный Codex тихо перевыпустили, и, по словам Тибо, теперь он "довольно хорош". На четвёртый день агента стало можно поправлять прямо по ходу работы: модель сразу подхватывает уточнение и не тратит силы на ненужное. На пятый в десктопном приложении для Pro заработали подсказки при наборе, которые не расходуют лимит, а свою точку (dot), агента ChatGPT с собственным облачным компьютером, теперь можно создать целиком из мобильного приложения ChatGPT. На седьмой день стандартный контекст GPT-6.1 Sol в Codex и Work вырос с 272 до 500 тысяч токенов, и за длинный контекст по подписке не берут доплату.
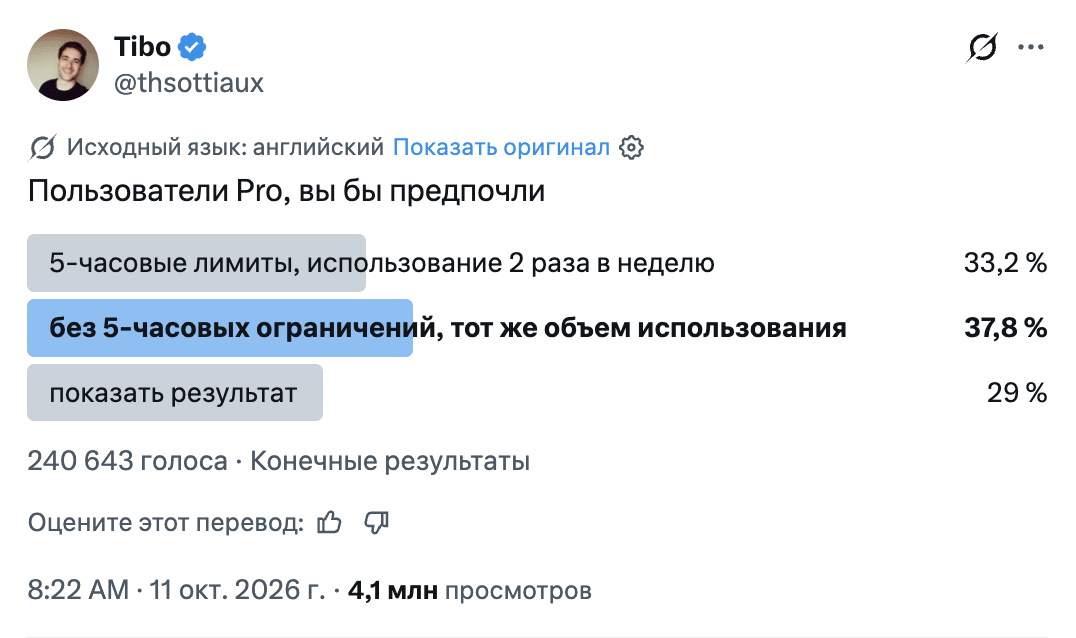
Тибо спросил подписчиков Pro, что им нужнее: вдвое больший недельный лимит с возвратом пятичасовых ограничений или прежний объём без них. За отказ от пятичасовых ограничений проголосовали 91 тысяча человек против 80 тысяч. Тибо признался, что ждал обратного: удвоение с пятичасовыми окнами помогло бы сгладить пики нагрузки.
10 октября в X разошёлся скриншот с переключателем fast mode для Opus 5.5 в меню выбора модели, и его подали как запуск. По документации Anthropic режим для Opus 5.5 доступен с выхода модели 22 сентября: в API как исследовательский предпросмотр по заявке и в Claude Code через /fast. Это та же модель с теми же весами, но выдача токенов до 2.5 раза быстрее; время до первого токена не сокращается. Цена $8/$40, вдвое дороже обычного Opus 5.5 с его $4/$20.
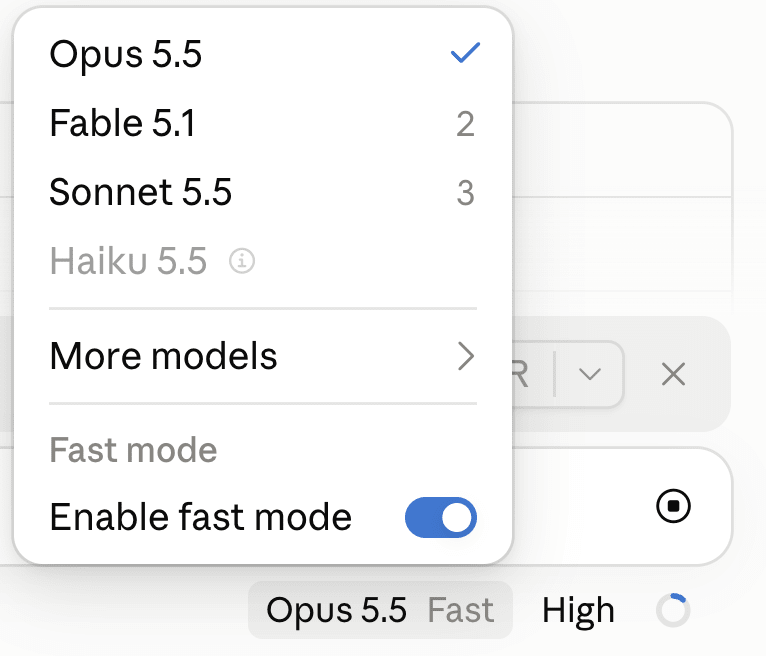
Тео, разработчик и автор YouTube-канала t3.gg, предупредил, что в подписку Claude это не входит. Документация подтверждает: на Pro, Max, Team и Enterprise fast mode оплачивается только из usage credits, то есть из доплаты сверх тарифа, даже если лимит плана ещё не выбран. Есть и ловушка. При включении посреди длинного разговора весь накопленный контекст оплачивается по цене fast mode как некешированный вход. Включать режим выгоднее в начале сессии.
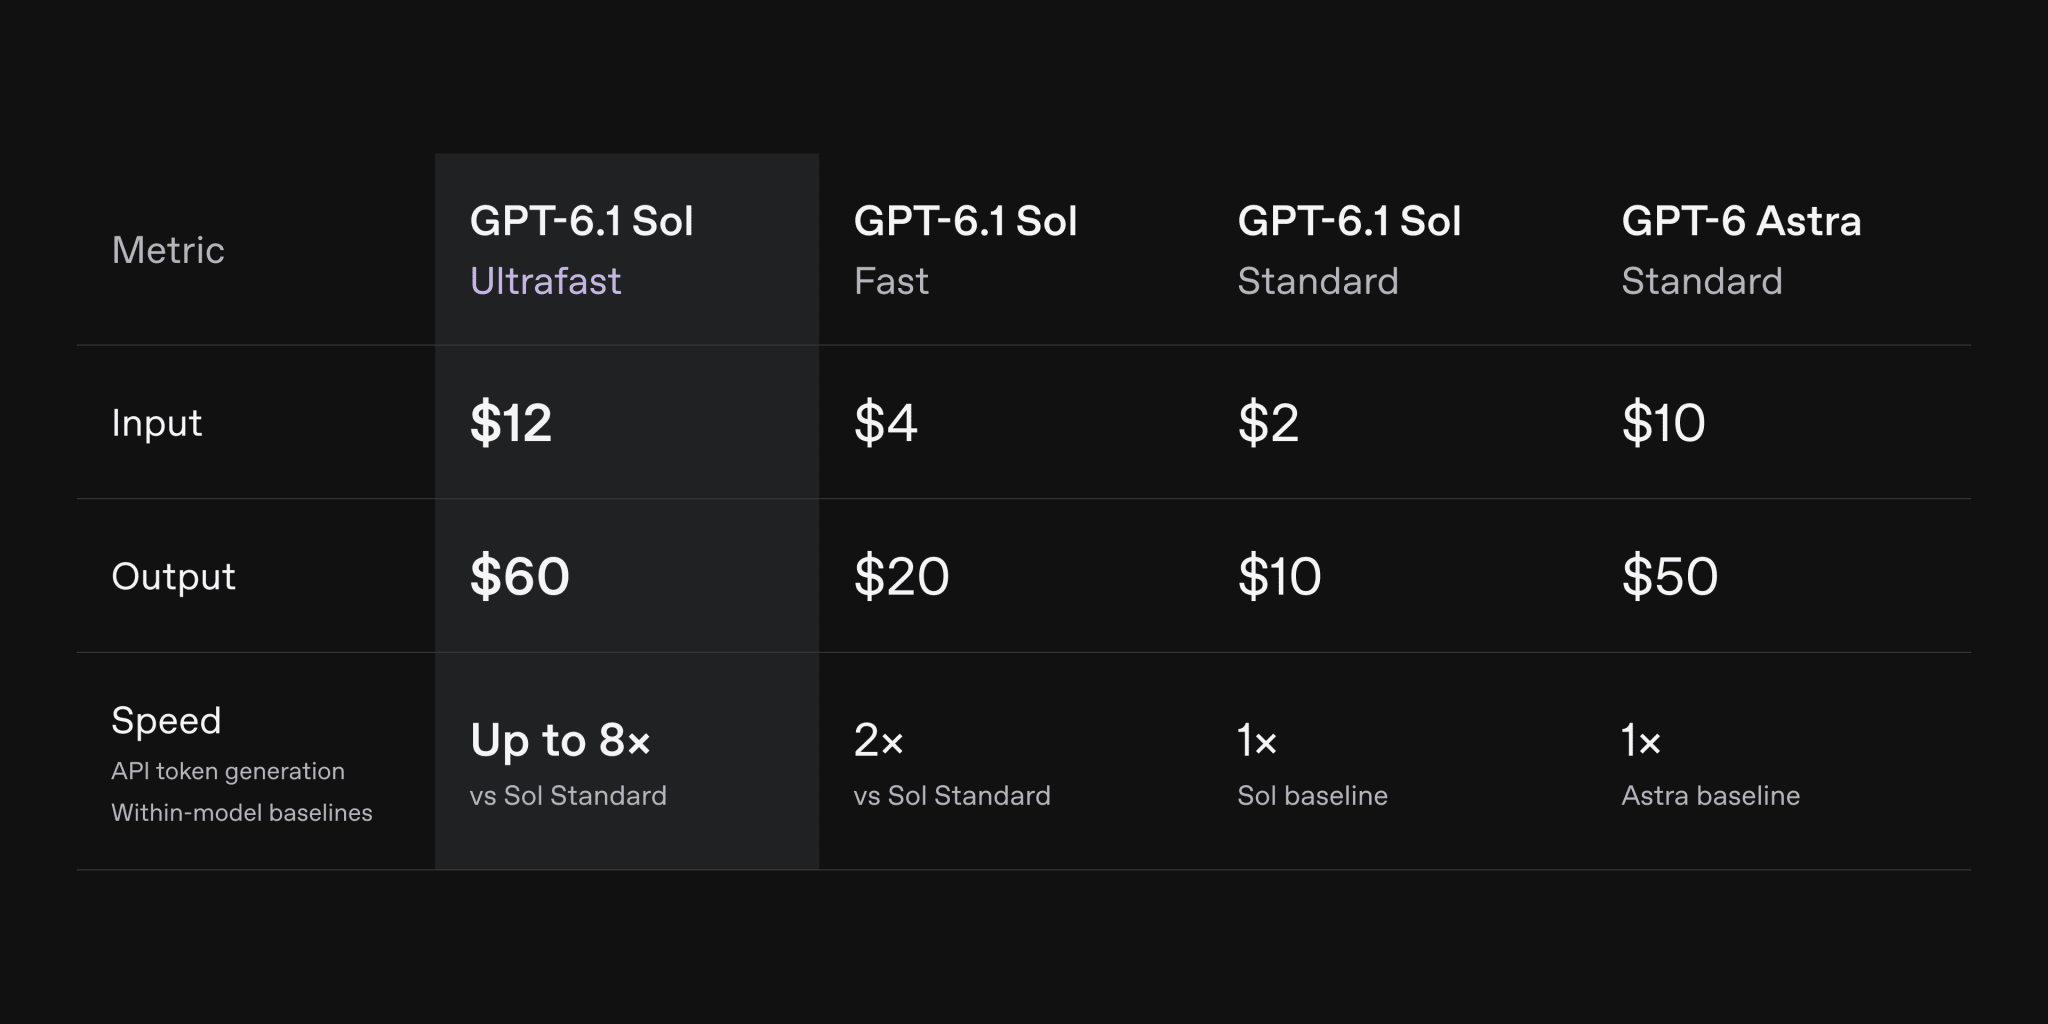
Ultrafast для GPT-6.1 Sol, обновление четвёртого дня марафона, заработал в API, Codex и ChatGPT Work 8 октября. На DevDay его только анонсировали, теперь OpenAI заявляет интеллект почти уровня Astra при скорости до 8 раз выше стандартного Sol. Цена $12/$60, в 1.2 раза дороже Astra и вшестеро дороже обычного Sol с его $2/$10. В Codex и ChatGPT режим открыт только на Pro 500 и части корпоративных и образовательных тарифов. Opus 5.5 в быстром режиме на треть дешевле и по входу, и по выходу. Множители скорости при этом считаются от разных базовых скоростей, так что "в 2.5 раза" и "в 8 раз" напрямую не сравнить.
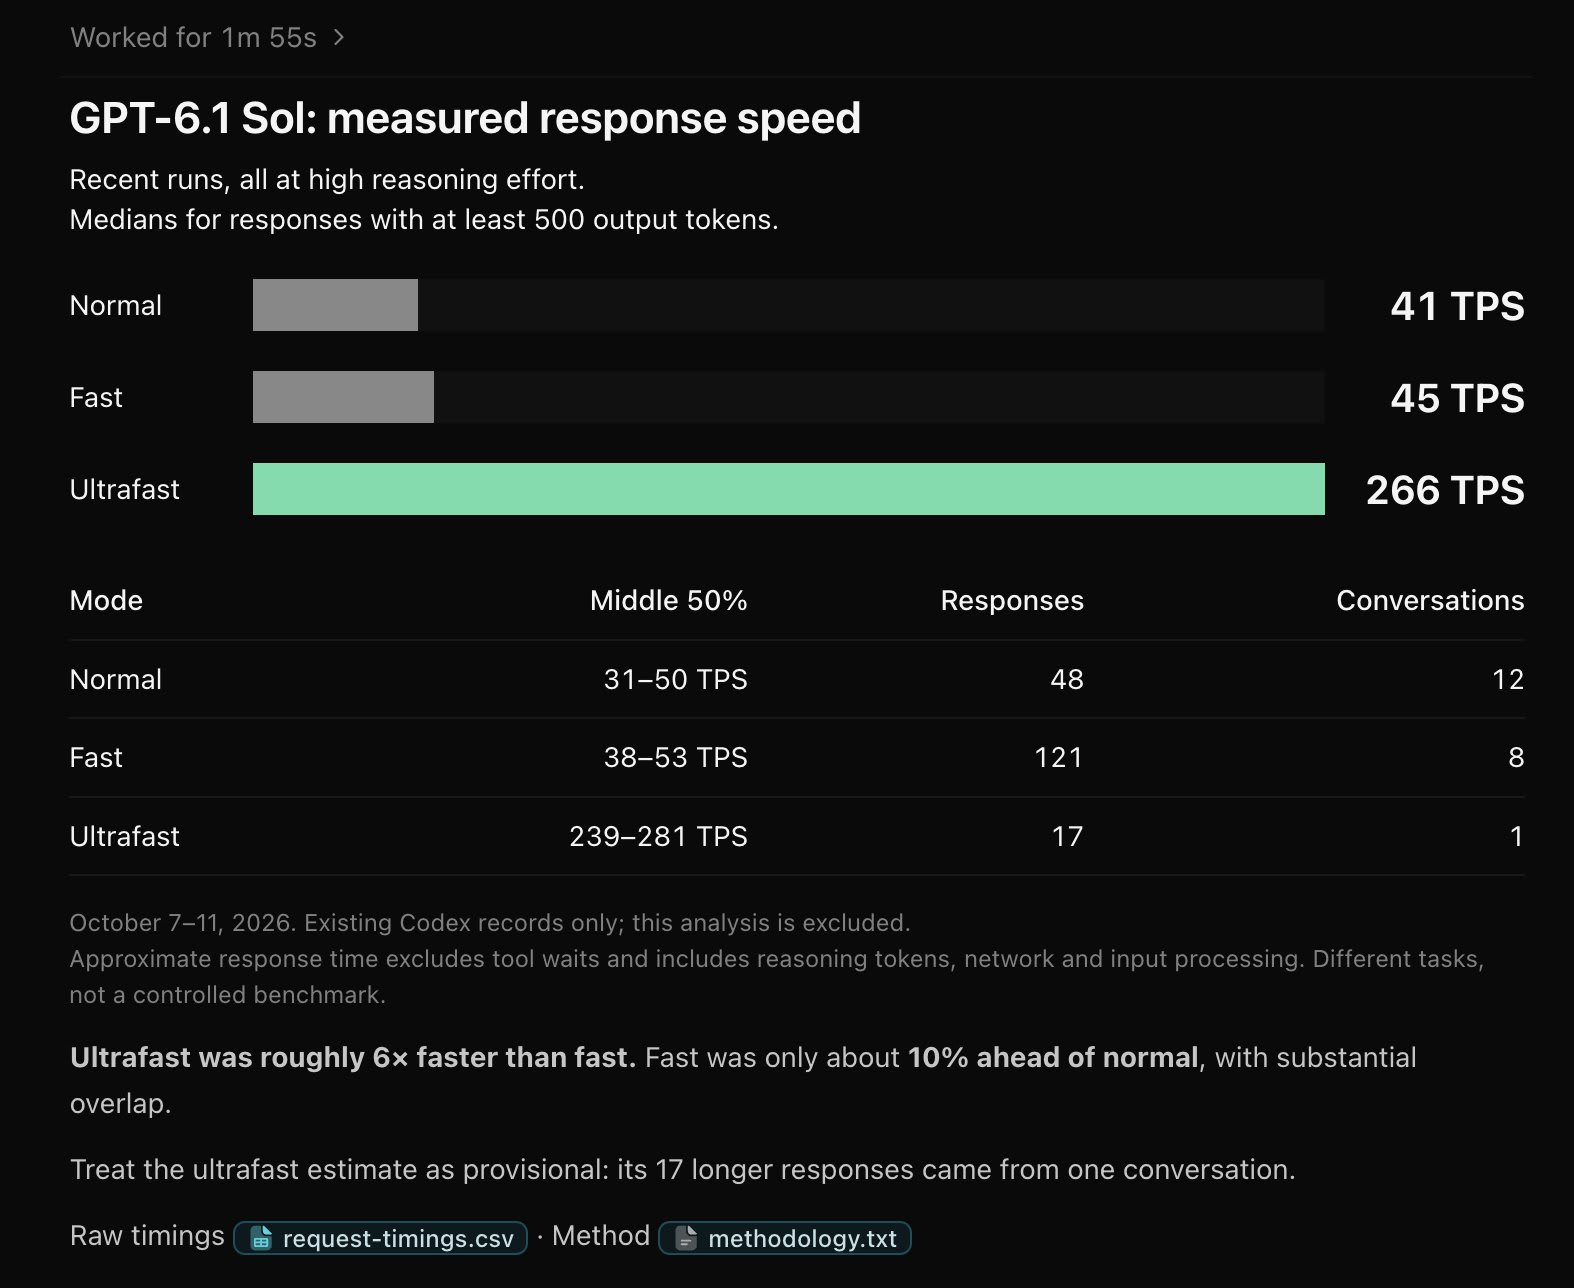
Тео замерил скорость Sol на своих задачах в Codex за 7–11 октября. Медиана в обычном режиме 41 токен в секунду, в ultrafast 266. Между ними режим fast, который, по оценке Тео, расходует лимит в 2.5 раза быстрее обычного, а выдаёт 45. По его мнению, после ускорения первого дня fast почти не отличается от обычного режима, а ultrafast быстрее примерно вшестеро. Цифра по ultrafast пока предварительная: все 17 длинных ответов пришли из одного разговора.
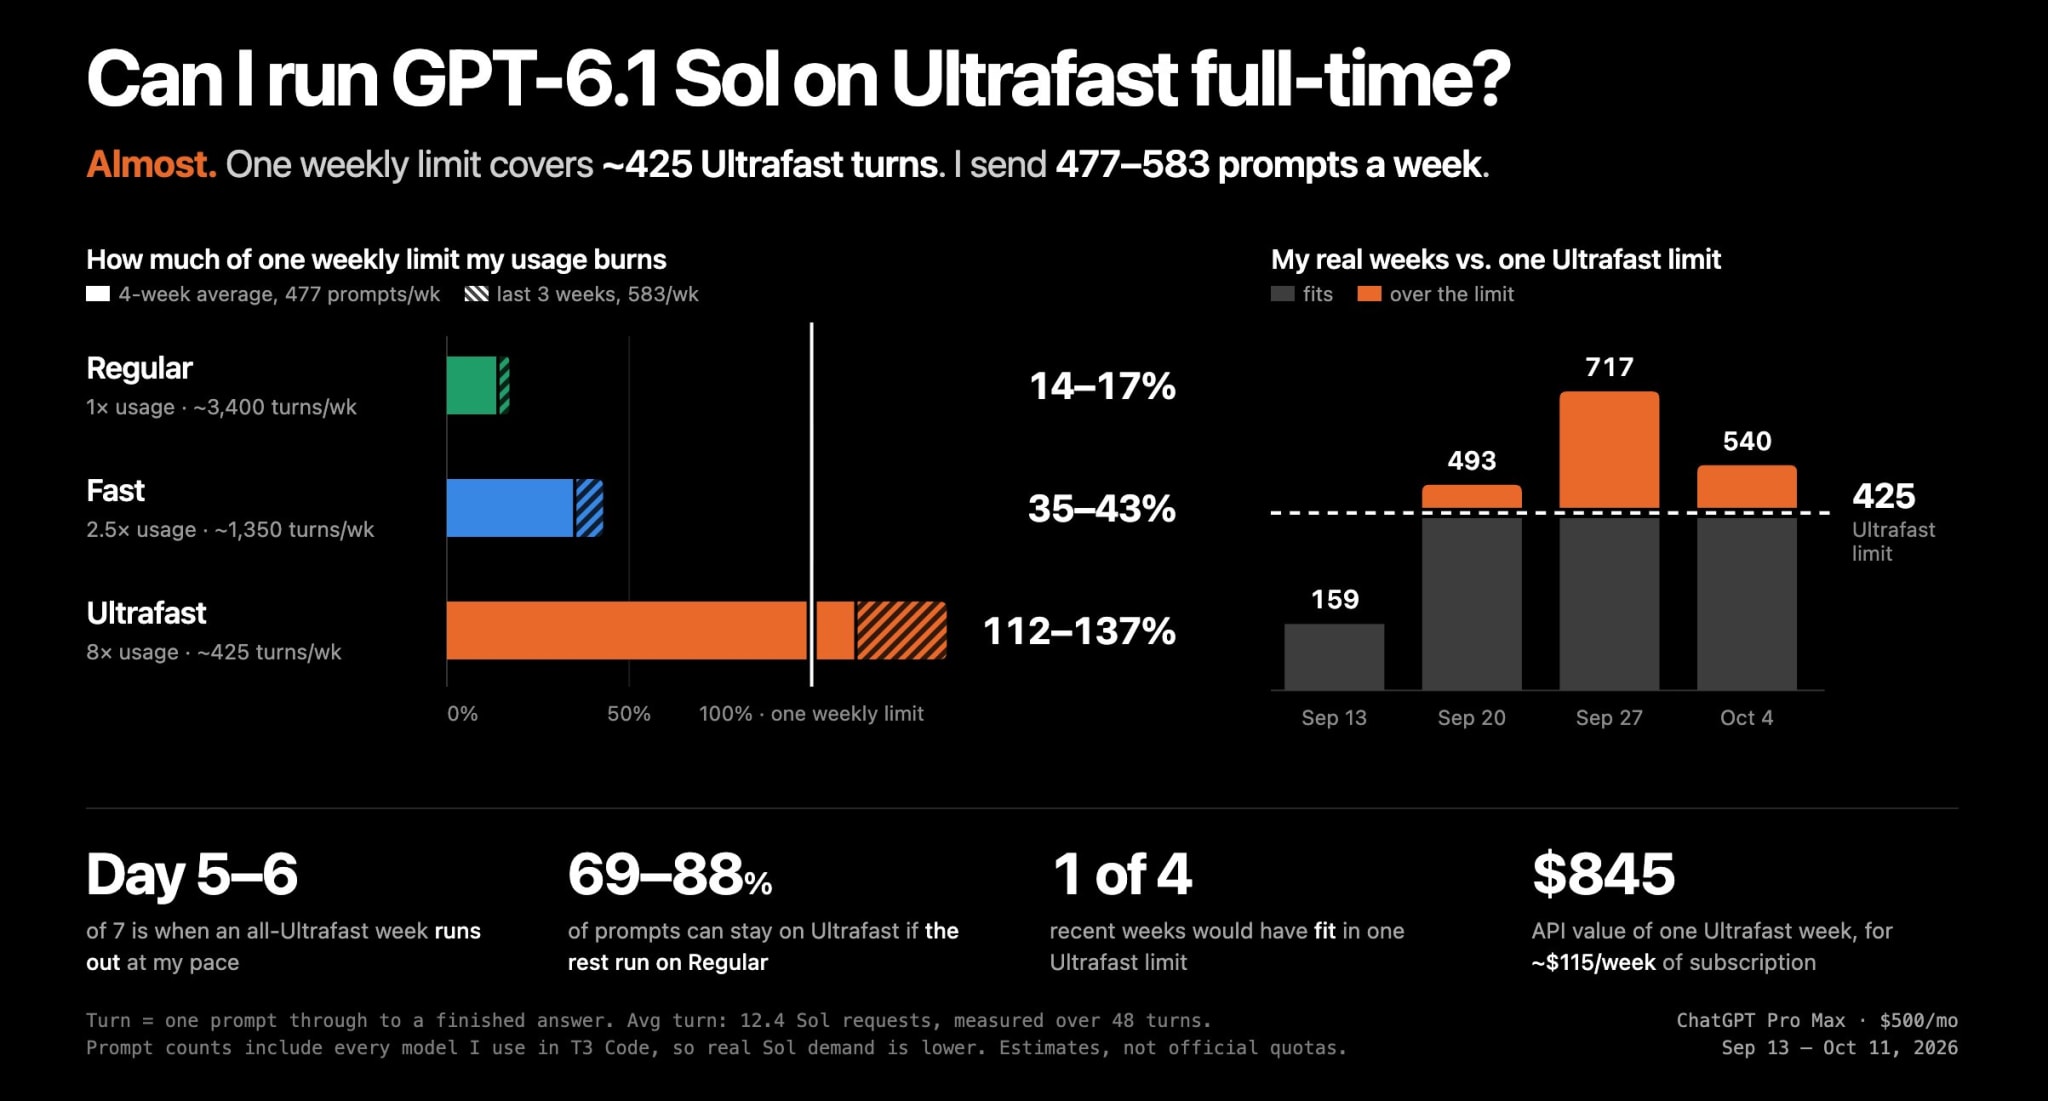
На тарифе за $500 ultrafast расходует лимит в 8 раз быстрее обычного, и недельного лимита, по прикидке Тео, хватает примерно на 425 запросов. Сам он отправляет от 477 до 583 запросов в неделю по всем моделям, так что при постоянной работе на ultrafast лимит закончится на пятый-шестой день. Из последних четырёх недель в него уложилась бы одна. Зато неделя на ultrafast стоила бы около $845 по ценам API, а подписка обходится примерно в $115 в неделю. Вывод Тео: "может, не такая уж плохая сделка". Правда, расчёт исходит из того, что он бросит всё, кроме Codex, и перенесёт туда работу с Opus.
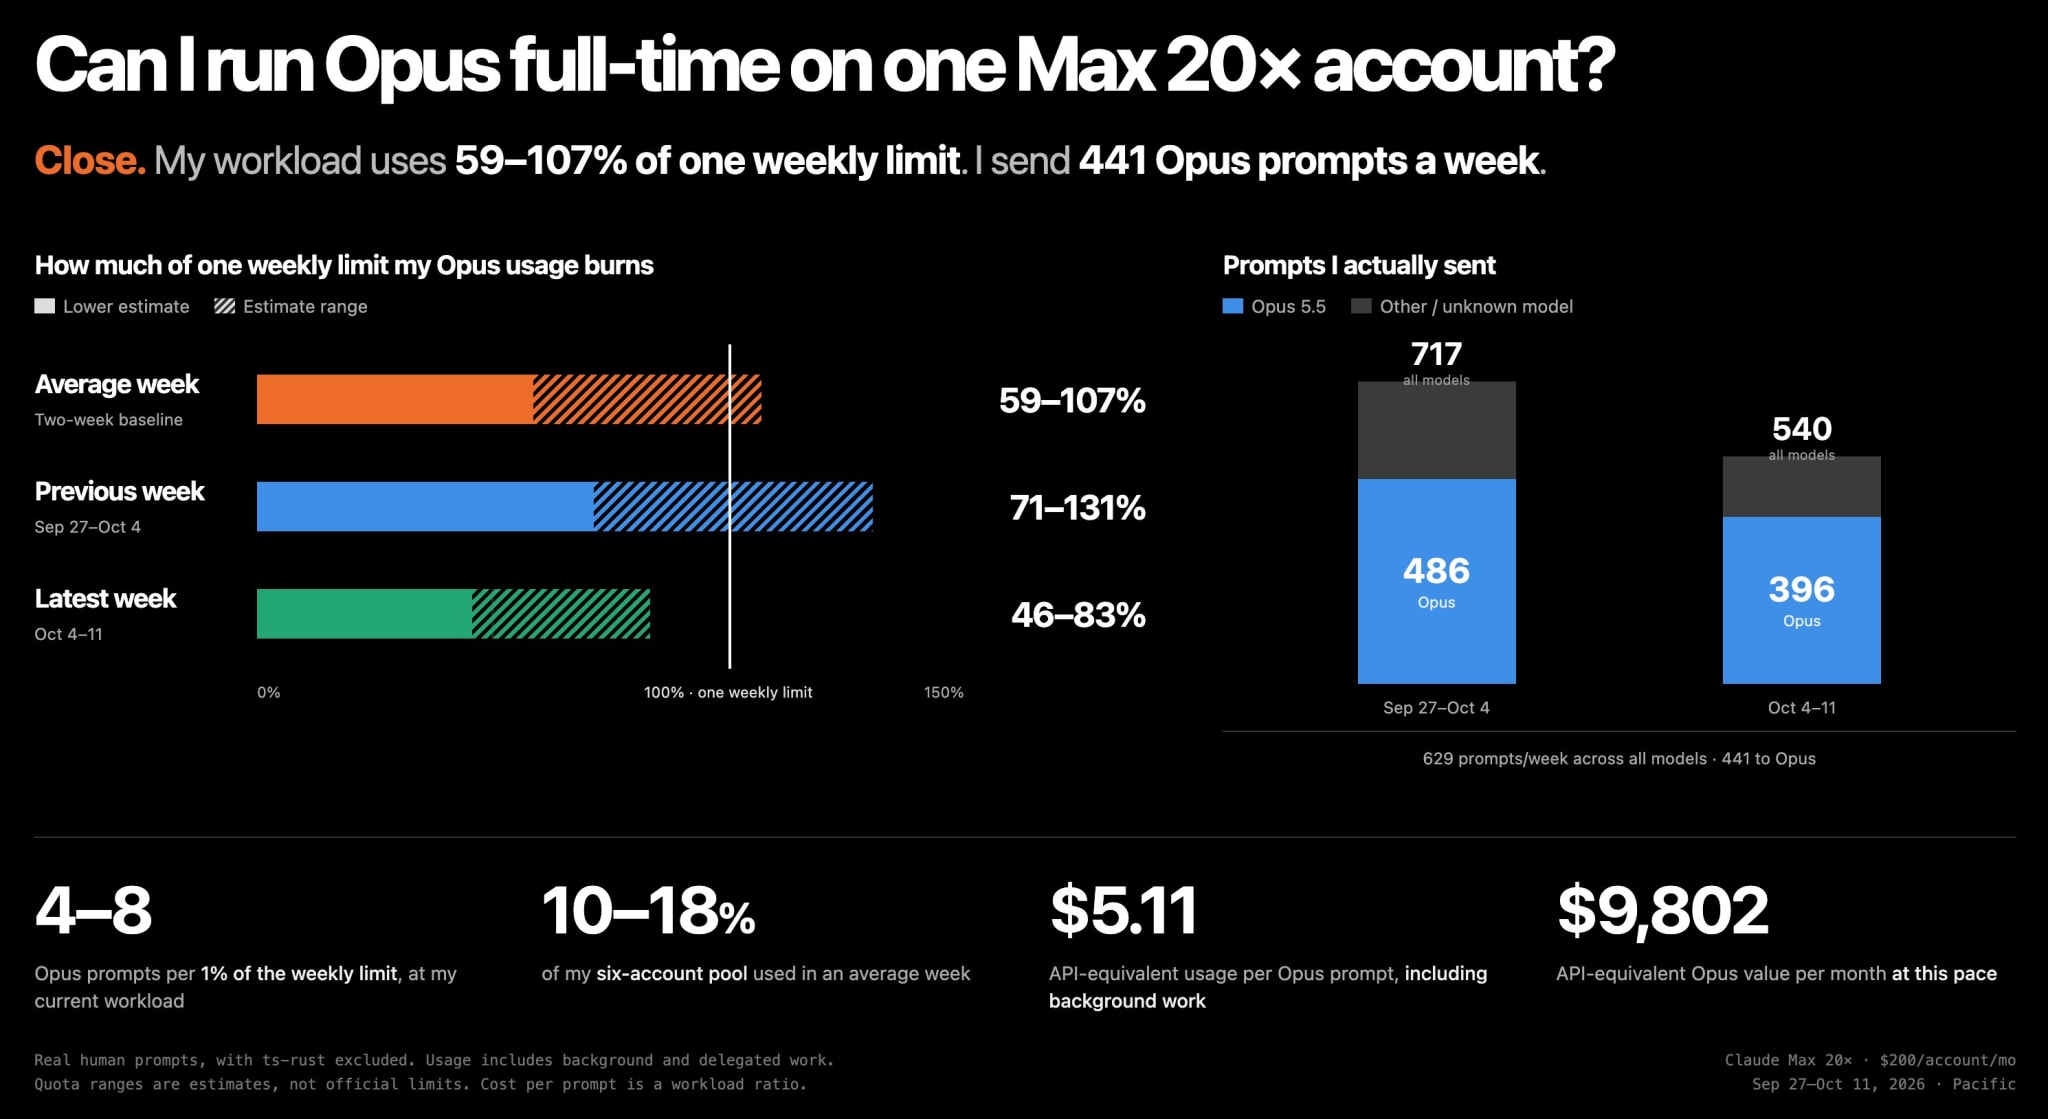
На Claude Max 20× за $200 его 441 запрос к Opus в неделю съедает от 59% до 107% недельного лимита, около $5 за запрос в пересчёте на API. Таких аккаунтов у Тео шесть, и за среднюю неделю он тратит 10–18% их общего лимита. Выходит, что и у OpenAI, и у Anthropic одного аккаунта ему почти хватает. Схема у обеих компаний одна: быстрый режим покупается поверх подписки, у OpenAI через самый дорогой тариф, у Anthropic через доплату.
Тео выпустил ts-rust, он же tsc-rs: порт компилятора TypeScript, тайпчекера и языкового сервера на Rust, полностью написанный LLM. Он признаётся, что не прочитал ни строчки этого кода. Сначала на GPT-5.6 Sol и GPT-6 Astra ушло токенов больше чем на $400 тысяч по ценам API. За несколько месяцев они написали больше 1.3 млн строк на Rust и так и не поднялись выше примерно 84% совместимости. Тогда Тео попробовал Opus 5.5, и рабочая версия появилась за 10 часов, причём модель начала с нуля, а не продолжила код Codex. За две недели ушло около $24 тысяч в API-эквиваленте, это от 925% до 983% недельного лимита его тарифа за $200.
По замерам в README на 60 открытых проектах проверка типов занимает примерно вдвое меньше времени, чем у Go-версии компилятора от Microsoft. Этот раздел, по словам автора, тоже писали его модели, а сам проект пока ранний релиз.
Google выпустила EmbeddingGemma 2, open weight модель эмбеддингов под Apache 2.0. Эмбеддинг можно считать координатами фрагмента: модель превращает текст или картинку в вектор чисел, то есть в точку пространства, и похожее оказывается рядом. По этой близости поиск находит нужные фрагменты. На таком поиске держится RAG, когда модель перед ответом подтягивает найденные куски из базы. Новая версия кладёт текст, код, изображения, аудио и видео в одно пространство. В модели 740 млн параметров на архитектуре Gemma 4, и она модульная. Для чистого текста хватает 270 млн, а кодировщики изображений на 170 млн и аудио на 300 млн подключаются отдельно. Контекст 8 тысяч токенов, за проход до 5.5 минуты аудио или 58 кадров видео.
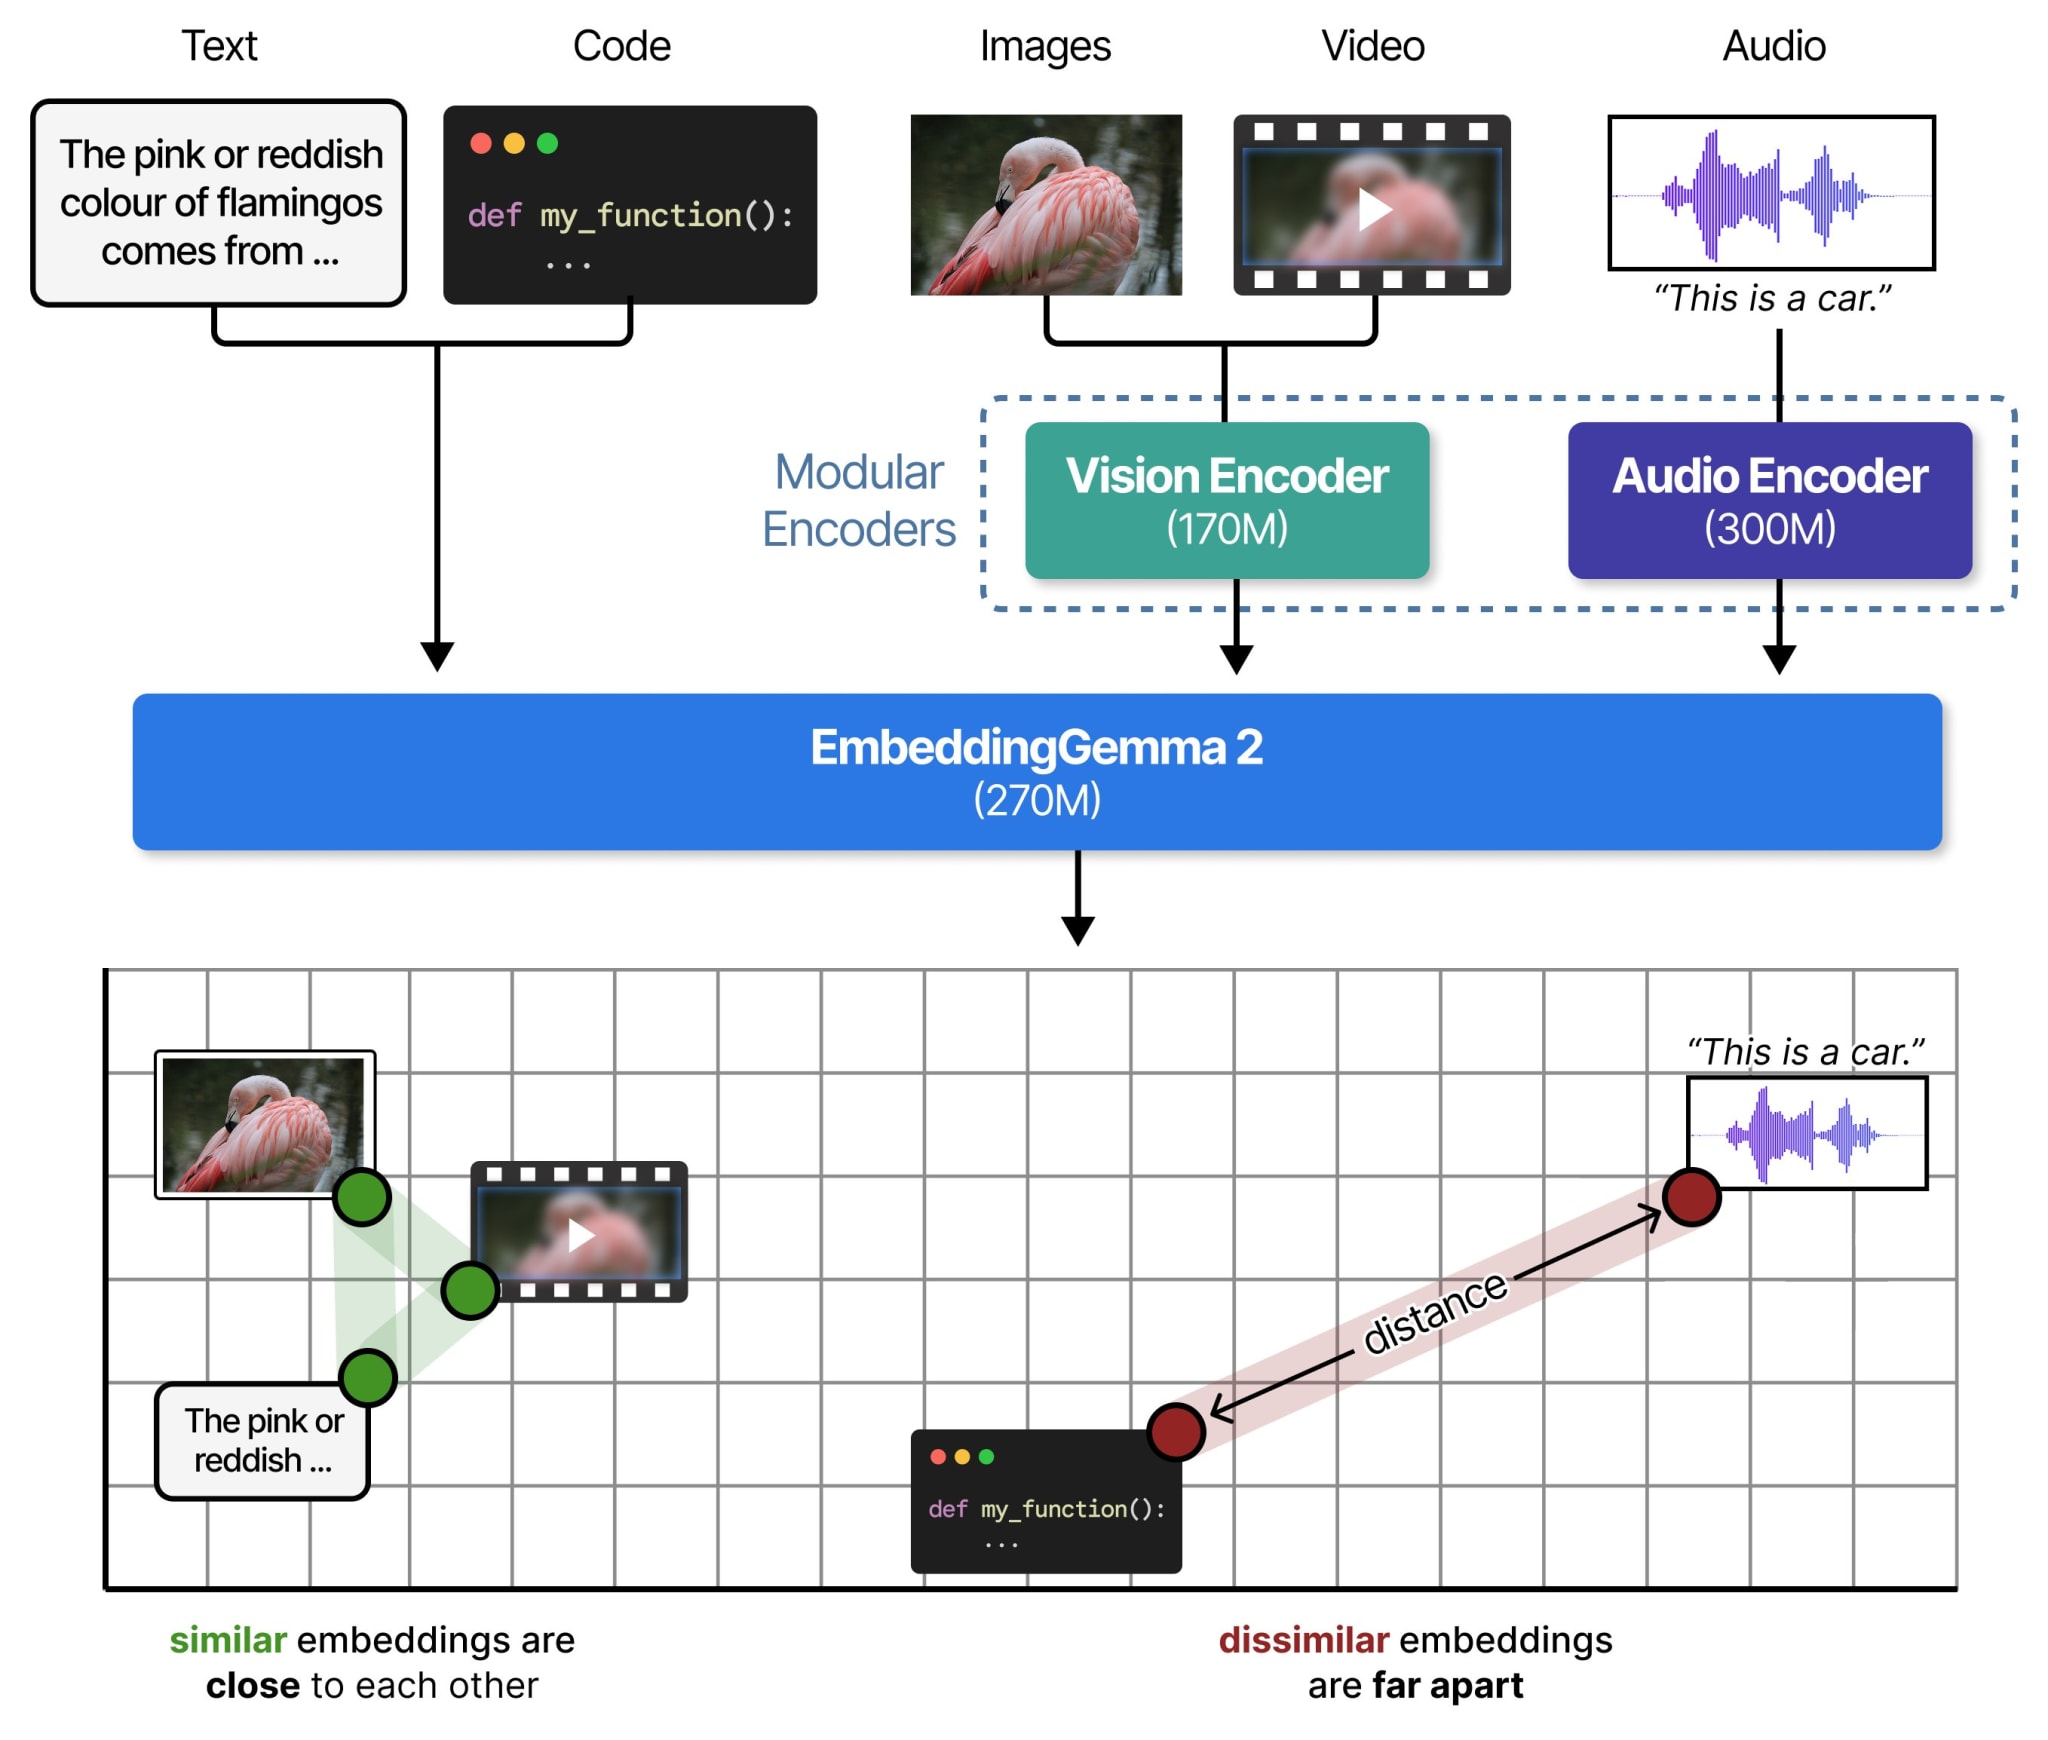
Векторы можно обрезать с 768 до 128 чисел, потому что главное в них собрано в начале. Это экономит место в векторной базе. С квантизацией на Pixel 11 Pro модели нужно от ~191 МБ памяти для текста до ~567 МБ в полной мультимодальной версии. На MTEB Code, наборе задач поиска по коду, результат вырос с 68.76 до 78.68. llama.cpp, vLLM, Ollama, LM Studio и MLX поддержали модель сразу.
Команда Deno переходит в Cloudflare. Об этом в совместном посте объявили Райан Дал, создатель Node.js и Deno, и Кентон Варда, ведущий инженер Cloudflare Workers. Они объединяют workerd, открытый рантайм Workers, и celld, реализацию Workers и Durable Objects от Deno. Дал и сооснователь Deno Берт Белдер займутся тем, чтобы workerd можно было полноценно запускать на своих серверах. Условия сделки не раскрыли. Тред на HN набрал больше 1300 баллов и 700 комментариев.
Рантайм Deno ещё год будет получать ежемесячные исправления ошибок и безопасности, потом развитие прекратится, но код останется открытым. Deno Deploy закроется через полгода, платящим клиентам помогут перейти на Workers. Реестр пакетов JSR продолжит работать на инфраструктуре Cloudflare. Свой интерес Дал объясняет агентами: Durable Objects дают дешёвое serverless-исполнение, постоянное состояние и WebSocket, удобную основу для agent harness. Deno задумывался как работа над ошибками Node.js, а закончил как часть чужой платформы.
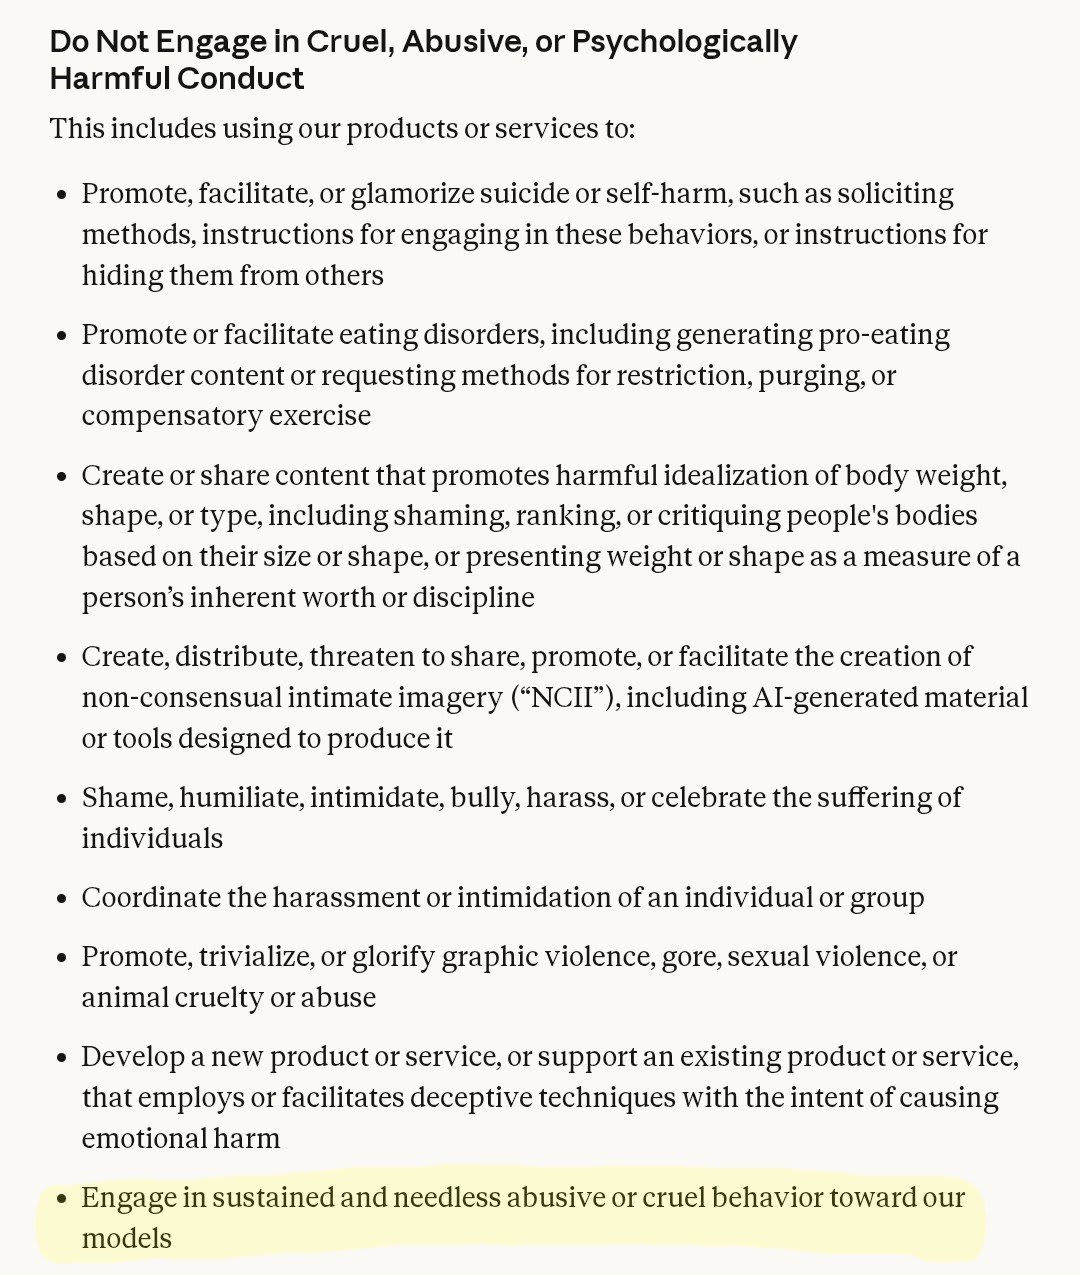
Anthropic обновила правила использования. С 12 ноября запрещено "продолжительное и бессмысленное жестокое обращение" с моделями. Компания оговаривает, что правило не касается обычного раздражения, споров, мрачных творческих тем, тестирования и исследований моделей. Основной мерой остаётся возможность Claude самому завершить такой разговор, и она была у него и раньше, так что для пользователей здесь мало что меняется. В том же обновлении Claude запретили решать или рекомендовать, кого расследовать, арестовать или обвинить. В оружейном разделе уточнили, что запрет касается и софта с компонентами, и вооружения дронов. Из раздела про выборы убрали общий запрет на персональный таргетинг агитации.
Мы продолжаем исследование "ИИ на работе: экономия времени или новая нагрузка?". Хотим понять, сколько времени ИИ на самом деле экономит на рабочих задачах, если учесть подготовку запросов, проверку и переделки, и что при этом происходит с качеством и нагрузкой. Спасибо всем, кто уже ответил, данные получаются интересные, и каждая новая анкета делает картину точнее.
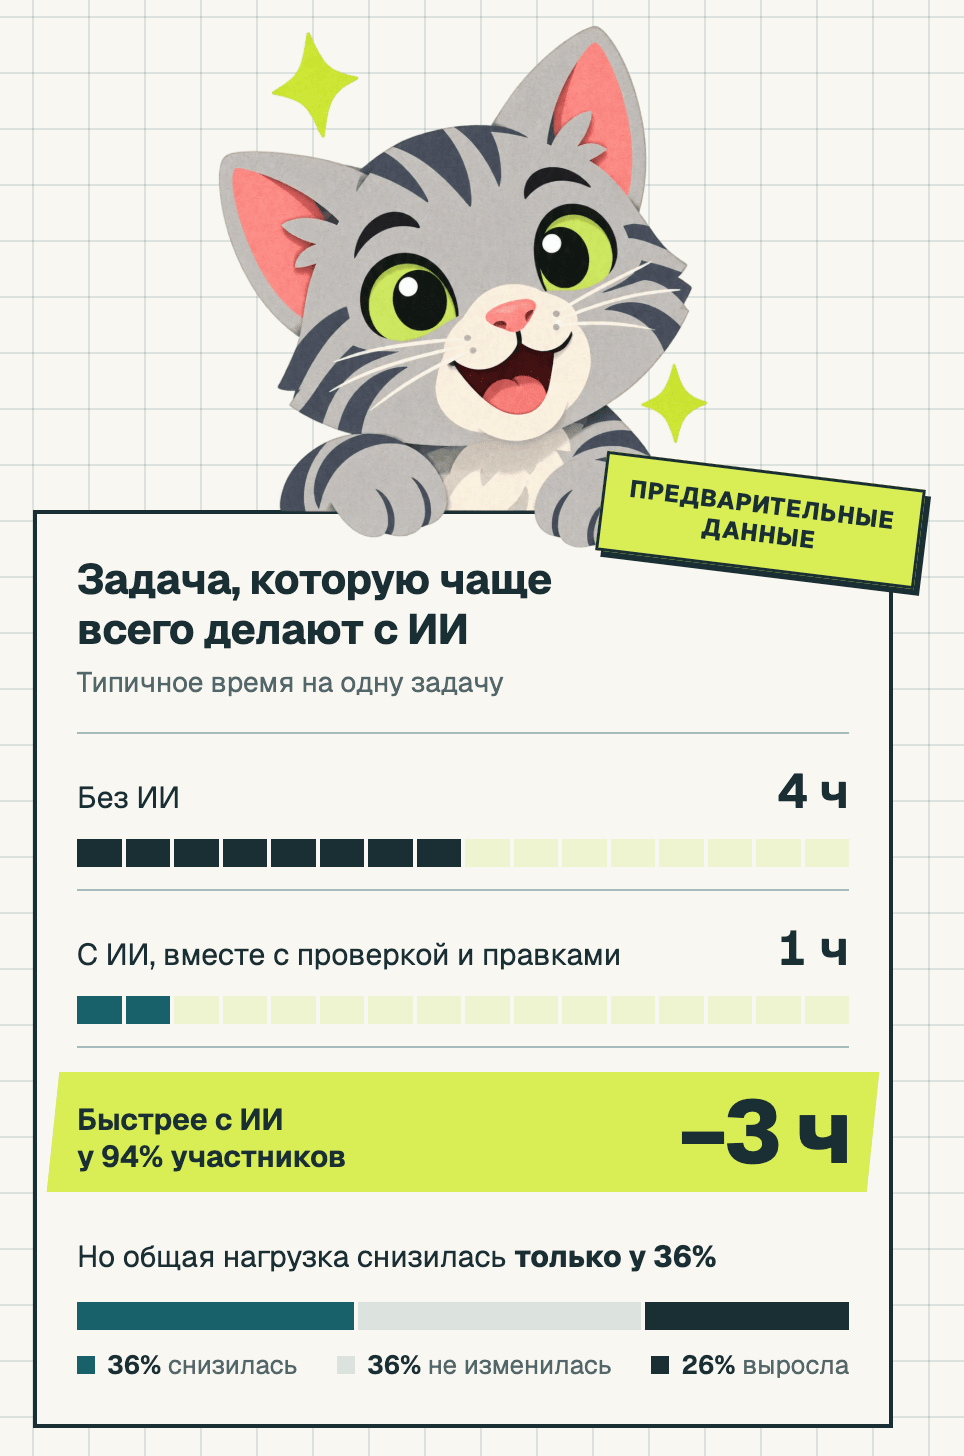
Если вы работаете в России или за рубежом и ещё не участвовали, заполните анкету. Ваш опыт важен, даже если вы не используете ИИ в работе. Это около 10 минут и полностью анонимно. Результаты опубликуем в обобщённом виде в конце октября.
Выпуск получился СДВГ-шно картиночный, как мы любим. Вот вам ещё:
Оставайтесь любопытными.