Jev: как устроен его API решений и что на нём уже строят
TL;DR: Jev — закрытая модель от TypeSafe для типизированных решений: приложение передаёт состояние и заранее задаёт допустимые ответы, а API возвращает выбор и вероятности вместо свободного текста. Такой контракт гарантирует форму результата, но не его правильность.
15 сентября TypeSafe показала Jev (произносится Джев) и запустила неделю технологического хайпа. Пост о запуске набрал около 33 млн просмотров. Через два дня браузерный агент уже искал авиабилеты за семь секунд, появился торговый бот, а разработчик заявил, что за час пересобрал Tesla Full Self-Driving на Jev. Ещё через день Jev появился в шлюзах, базах данных, плагинах и фильтрах контента.
Я изучил сотню постов и проектов на Jev в Twitter, Reddit и GitHub и выбрал 15 самых показательных кейсов. Ниже — API-контракт, устройство jev-ultrafast, арифметика тех самых семи секунд и разбор того, чему во всех этих демо вообще можно верить.
Что такое Jev: на выходе не текст, а допустимое решение
Обычная LLM получает контекст и продолжает последовательность токенов. Даже когда мы просим JSON, её работа по сути остаётся генерацией: модель пишет сериализованный объект, валидатор проверяет форму, а при ошибке начинаются знакомые повторные попытки.
Jev принимает другой контракт:
state + questions → answers + probabilities
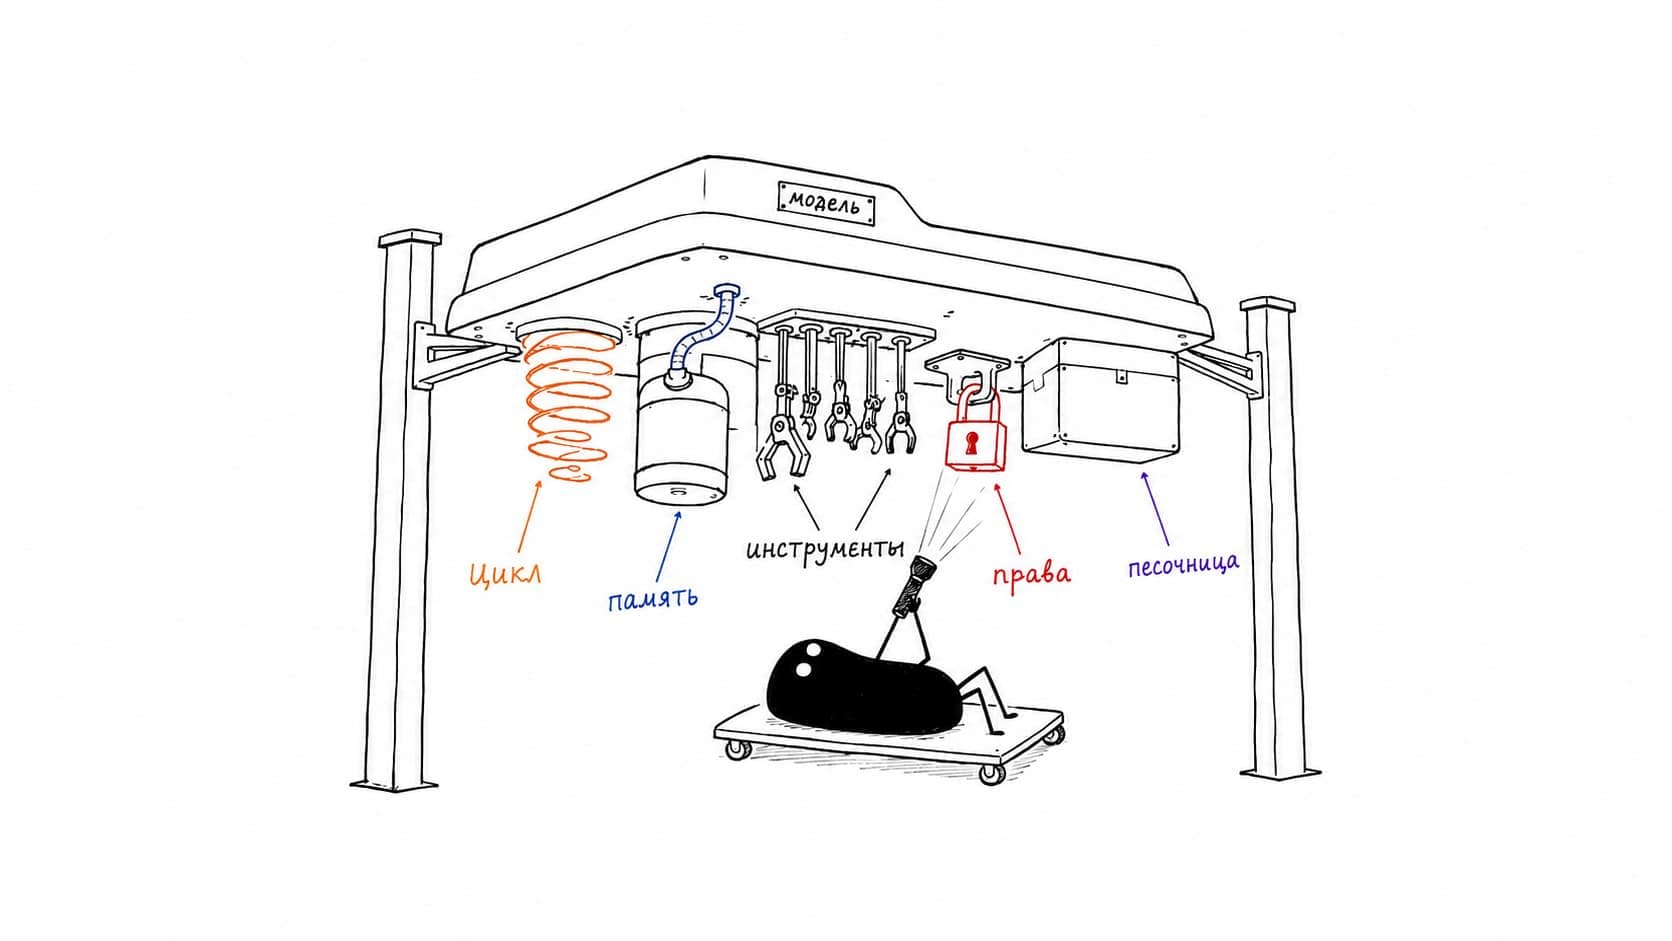
В state лежит текст или структурированное состояние приложения. В questions разработчик задаёт один или несколько типизированных вопросов. Ответы возвращаются под теми же ключами. Публичных примитивов три:
Noulотвечает на вопрос да/нет вероятностью от 0 до 1;Choiceвыбирает один из заранее заданных вариантов и возвращает распределение по всему списку;Scoreраспределяет вероятность по шкале из 2–10 уровней и считает математическое ожидание.
Возьмём обращение в поддержку: "С меня дважды списали деньги, исправьте срочно". Одним запросом можно спросить, есть ли срочность (Noul), какой отдел должен взять тикет (Choice) и насколько клиент раздражён (Score). Все вопросы видят общий state, но не ответы друг друга. Если второй вопрос должен зависеть от первого, эту зависимость придётся собрать в коде.
Независимость вопросов позволяет использовать speculative fan-out. Приложение заранее отправляет вопросы для нескольких возможных ветвей, получает ответы одновременно, а затем код выбирает нужные. Часть ответов может не пригодиться, зато не нужно ждать следующего обращения к API.
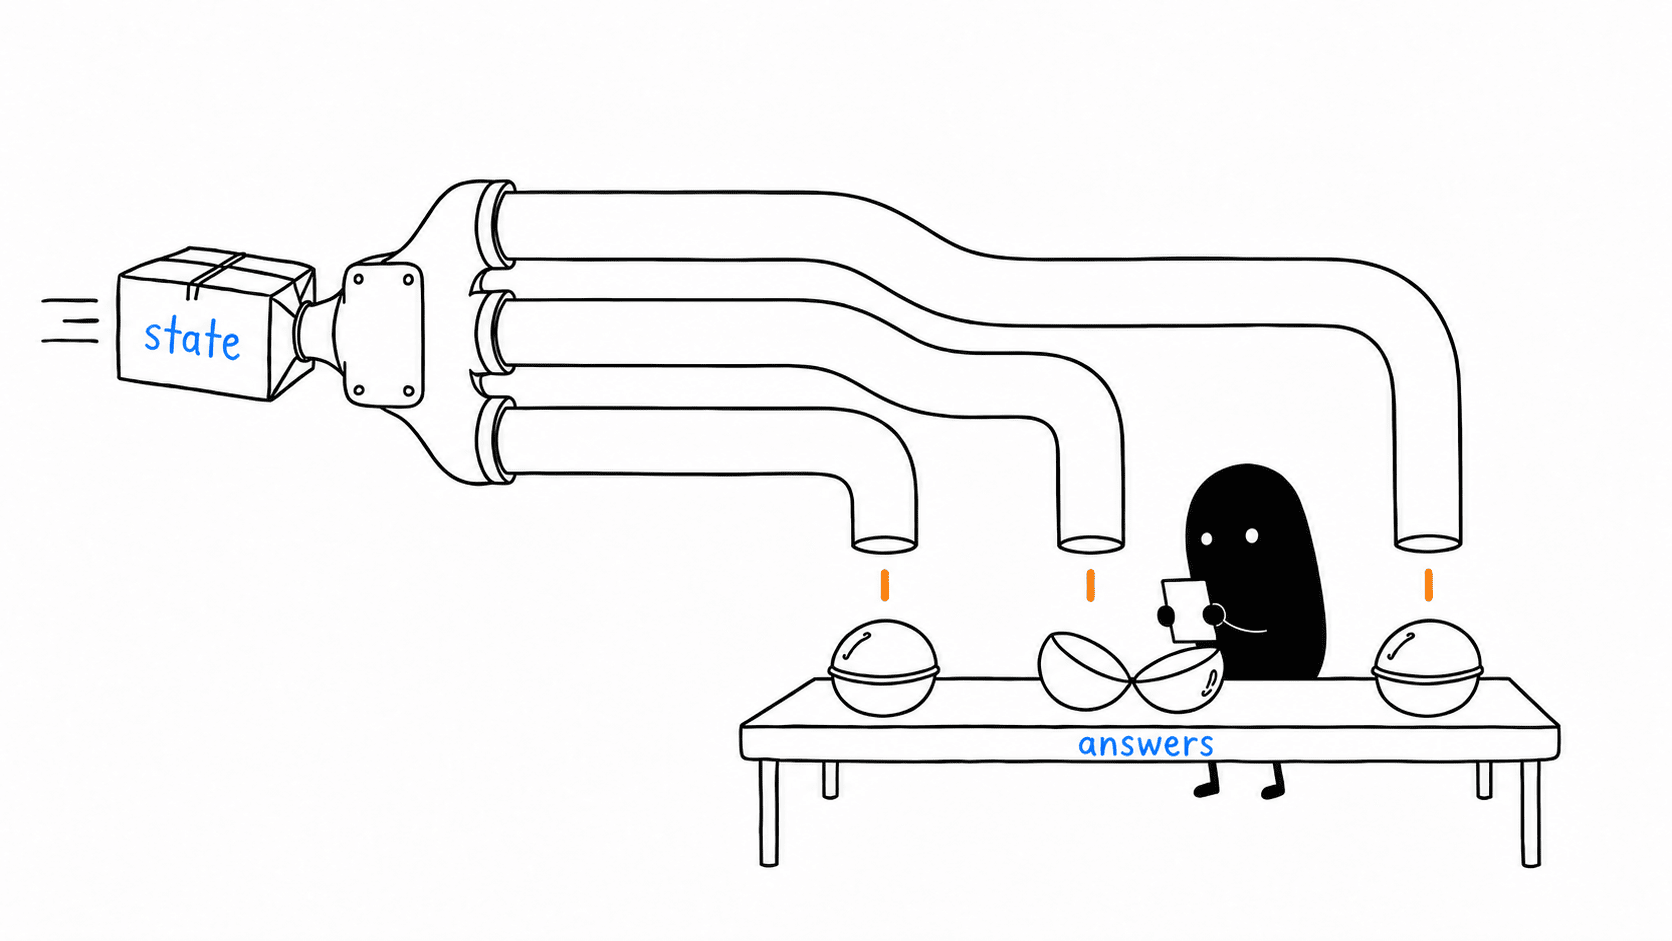
На этой особенности держится любимая формулировка запуска: "ноль галлюцинаций". В узком смысле она верна. Если допустимы только billing, technical и sales, API не вернёт legal, длинное объяснение или стихотворение про возвраты. Но Jev вполне может уверенно выбрать sales. Типобезопасность гарантирует форму и множество допустимых ответов, а не фактическую правильность.
С confidence та же ловушка. Это характеристика формы распределения, а не вероятность того, что решение верно. Значение 0,9 не означает "ошибётся в одном случае из десяти". TypeSafe прямо рекомендует калибровать пороги на собственных размеченных данных и учитывать цену ошибки. Для модерации комментария, блокировки платежа и удаления production-базы один порог явно не подойдёт.
О System One и методе обучения RLCD, Reinforcement Learning for Calibrated Decisions, пока известно только из описаний TypeSafe. Компания не опубликовала веса, архитектуру, данные, функцию потерь и схему вознаграждения. Опыты Archer Hume согласуются с изоляцией вопросов и показывают влияние всего списка вариантов. Но каузальный декодер, KV-кэш, отдельные выходные головы и тем более разреженная MoE-модель из этого не следуют.
Пока у Jev можно проверить только то, что происходит на границе модели и приложения. Похожий интерфейс можно собрать поверх LLM со structured output, constrained decoding или локального logit-scoring; даже TypeSafe открыла адаптер System One для обычных LLM. Поэтому интерфейс стоит оценивать по качеству модели, калибровке, задержке и поведению всей системы в эксплуатации.
| Подход | Что даёт | Где граница |
|---|---|---|
| Jev | Динамические вопросы, полные распределения, пакетный decision API | Закрытое ядро, облачная зависимость, своя калибровка |
| LLM со structured output | Можно одновременно решить задачу, объяснить ход и написать текст | Форма и вероятности зависят от реализации, возможны проверка и повторный запрос |
| Constrained decoding | Декодер не позволяет сломать синтаксическую схему | Валидный JSON всё ещё может содержать неверное решение |
| Узкий классификатор или reranker | Локальность и высокая точность на стабильном домене | Меньше zero-shot-гибкости, нужны данные и настройка |
| Детерминированный код | Предсказуемость, тестируемость и нулевая модельная цена | Плохо справляется с нечётким семантическим соответствием |
Josh Kuechly сравнил Jev и open-weight классификатор GLiNER 2.5 на Banking77. Без дообучения GLiNER уступил Jev примерно 9 процентных пунктов, хотя работал в 10 раз быстрее. После 51 минуты обучения на примерно 10 тысячах примеров он отыграл 18 пунктов, обошёл Jev примерно на 9 и работал в 8 раз быстрее локально. Код и логи автор не опубликовал, поэтому это пока один эксперимент, а не независимый бенчмарк. Но развилка получилась наглядной: Jev покупает zero-shot-гибкость, узкий классификатор — скорость и точность на стабильной задаче.
Jev не отменяет эти варианты. Он добавляет ещё один: универсальный облачный слой решений между обычным кодом и LLM.
Как попробовать Jev, не дожидаясь раскрытия TypeSafe
Попробовать Jev можно на askjev.ai или easyjev.app.
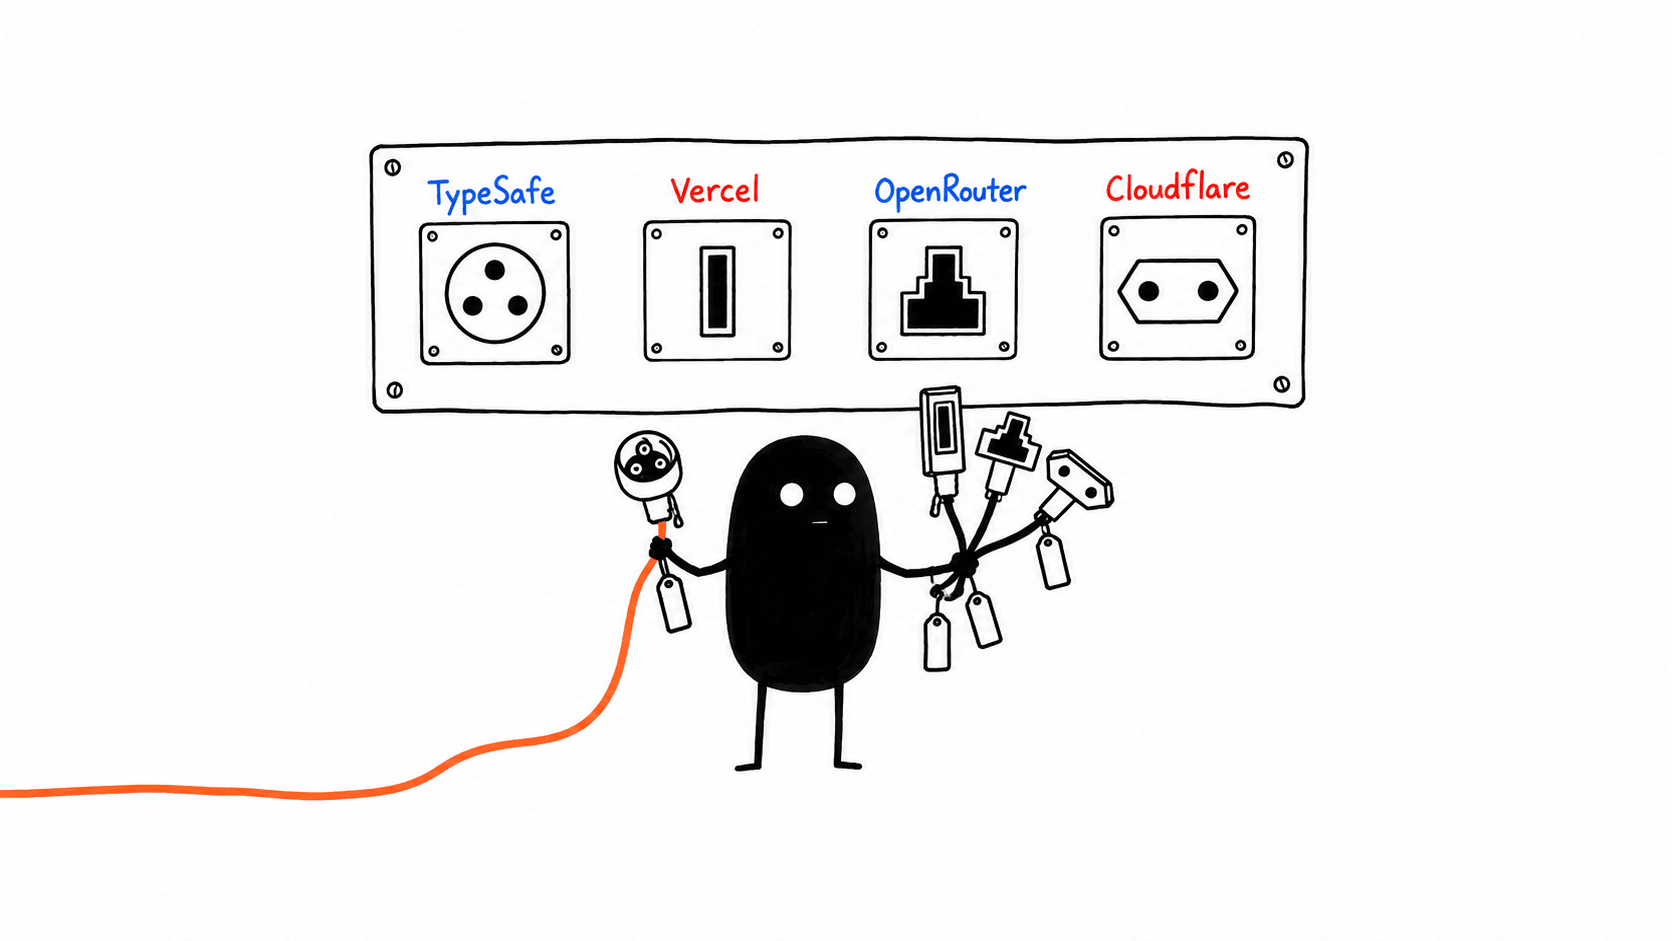
Прямой доступ TypeSafe на момент проверки 18 сентября оставался в early access. После допуска пользователь создаёт ключ, покупает кредиты и вызывает POST /v1/systemone. Не дожидаясь прямого допуска, Jev можно было вызвать через Vercel AI Gateway, где модель называется typesafe-ai/jev и оплачивается кредитами Vercel. OpenRouter использует ранний endpoint /api/alpha/decisions, а Cloudflare Workers AI вызывает typesafe/jev через свой ai/run. Это четыре разных маршрута с собственными ключами, биллингом и ограничениями, а не взаимозаменяемые прокси.
На 18 сентября алиасы jev-latest и jev-preview указывали на jev-1.13.0. Документация модели называла цену $0.042 за миллион входных токенов; выходные токены не тарифицировались. Лимиты раннего доступа: 64k токенов на запрос, 32k для совокупной длины state и самого длинного вопроса, 1200 запросов в минуту и 250 тысяч входных токенов в секунду. TypeSafe предупреждала, что лимиты могут меняться.
Минимальный запрос из официального quick start выглядит так:
curl -X POST https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d @- <<'EOF'
{
  "state": "Hi, I've been trying to connect my Stripe account for 3 days and it keeps failing. I'm losing sales. Please help ASAP.",
  "model": "jev-latest",
  "questions": {
    "urgency": {
      "type": "noul",
      "instructions": "Does this message express urgency?"
    }
  }
}
EOF
Запрос показывает контракт: состояние отправляется целиком, вопрос типизирован, свободного поля для текстового ответа нет. SDK для Python и JavaScript прячут HTTP-вызовы и повторы, но не меняют модель работы.
Цена выглядит почти неприлично низкой, пока не вспомнишь, что агент заново отправляет большой контекст на каждом шаге и за все его токены приходится платить. Выходные токены бесплатны, потому что их мало, а не потому, что вся цепочка ничего не стоит.
TypeSafe заявляет, что не обучает Jev на пользовательских запросах и ответах, но для обычного аккаунта с прямым доступом не публикует конкретный срок хранения. ZDR предлагают корпоративным клиентам. Vercel не сохраняет запрос и ответ после завершения вызова, однако хранит операционные метаданные, а детали попыток маршрутизации могут жить 30 дней. "Не используем для обучения" и "ничего не храним" всё-таки разные обещания.
Для прямого аккаунта Master Customer Agreement TypeSafe ограничивает обратную разработку и публикацию бенчмарков или сведений о производительности сервиса. Это может касаться не только собственных замеров.
Как устроен браузерный агент на Jev
Браузерный агент начинается не с модели. Репозиторий jev-ultrafast удобен тем, что хайповый ролик можно развернуть обратно в код. Разбирать будем MVP версии 0.1.0 на зафиксированном коммите: Jev в нём выбирает следующее действие, а браузерную механику реализует код агента.
Один цикл выглядит так:
snapshot.js
  → видимый текст и индексированный action space
  → пакет вопросов Choice
  → Jev выбирает операцию и цель
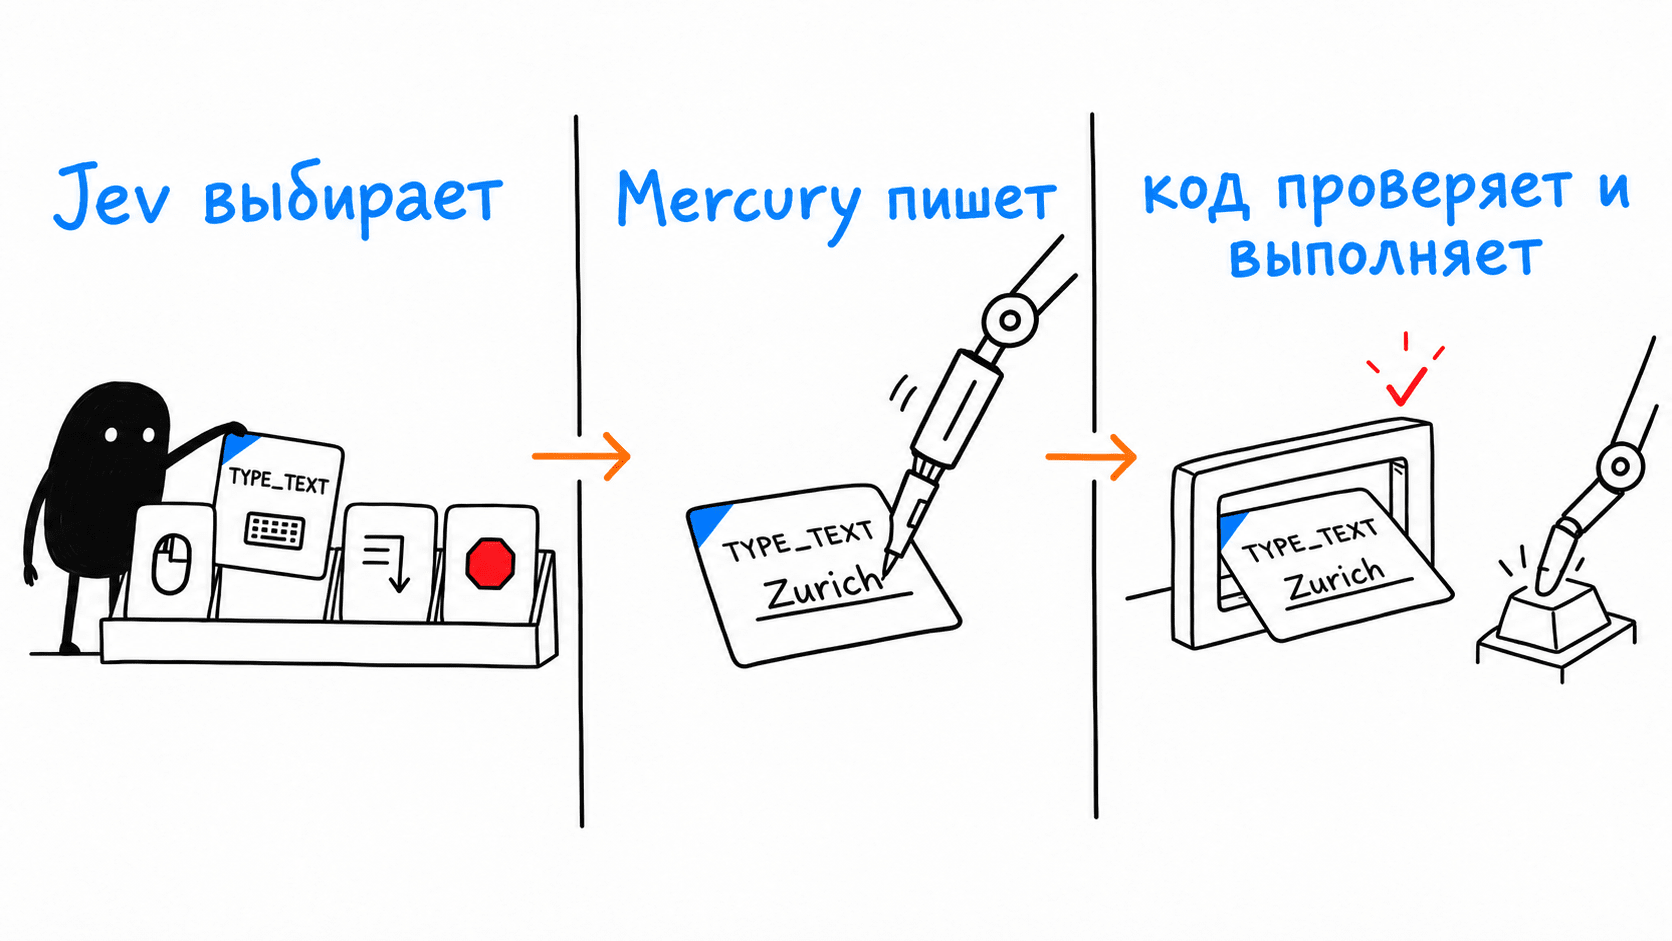
  → Mercury 2.5 пишет значение только для TYPE_TEXT
  → browser.py проверяет и исполняет действие
snapshot.js собирает видимый текст и интерактивные элементы поддерживаемых типов. Обычный Python-код превращает их в список разрешённых операций: CLICK, TYPE_TEXT, SELECT, прокрутка, ожидание, DONE и BLOCKED. Jev не придумывает CSS-селектор, координаты, JavaScript или shell-команду. Он видит уже построенный список и выбирает индекс.
В model.py вопрос об операции и вопросы о целях собираются одним пакетом. Вот реальный фрагмент функции choose():
questions = {
    "operation": {"type": "choice", "criteria": operations, "instructions": {"goal": goal, "rules": NEXT_ACTION}}
}
Следующий цикл добавляет в questions цели из наблюдённых элементов. Jev параллельно оценивает operation, click_target, type_text_target и другие ветви. Если победил CLICK, ответ для type_text_target не используется.
Свободный текст всё равно нужен, когда агент заполняет поле. Строки Zurich и London в демо сгенерировала Mercury 2.5, а не Jev. После выбора исполнитель заново проверяет страницу, DOM-узел, свойства, геометрию и перекрытие элемента. Модель предлагает действие, код решает, можно ли его физически выполнить.
Это сильная архитектурная граница, но она же показывает, куда уехала сложность. Action space обрезается до первых 250 записей, видимый текст до 6000 символов. Первая версия не поддерживает или поддерживает лишь частично фреймы, <canvas>, загрузку файлов, новые вкладки, вложенную прокрутку, shadow DOM и нестандартные элементы. Если нужная кнопка не попала в снимок, Jev не выберет её даже с идеальной точностью.
В issues уже есть пустое первое пространство действий, невидимые кликабельные элементы и отчёт о прогоне на 81,62 секунды: два тайм-аута Page.captureScreenshot и ручные возобновления увеличили полное время, а фоновое ограничение рендеринга автор назвал вероятной причиной. По этим единичным отчётам нельзя оценить частоту отказов. Они обозначают три точки для проверки: полноту пространства действий, видимость интерактивных элементов и устойчивость браузерной среды.
Проверки свежести и геометрии отсеивают действия по устаревшему состоянию страницы, но не защищают от prompt injection. В проекте нет общей политики подтверждения опасных операций и списка разрешённых доменов. Узкий набор разрешённых действий сужает круг возможных ошибок, но сам по себе не делает выбранное действие безопасным.
Что на самом деле поместилось в семь секунд
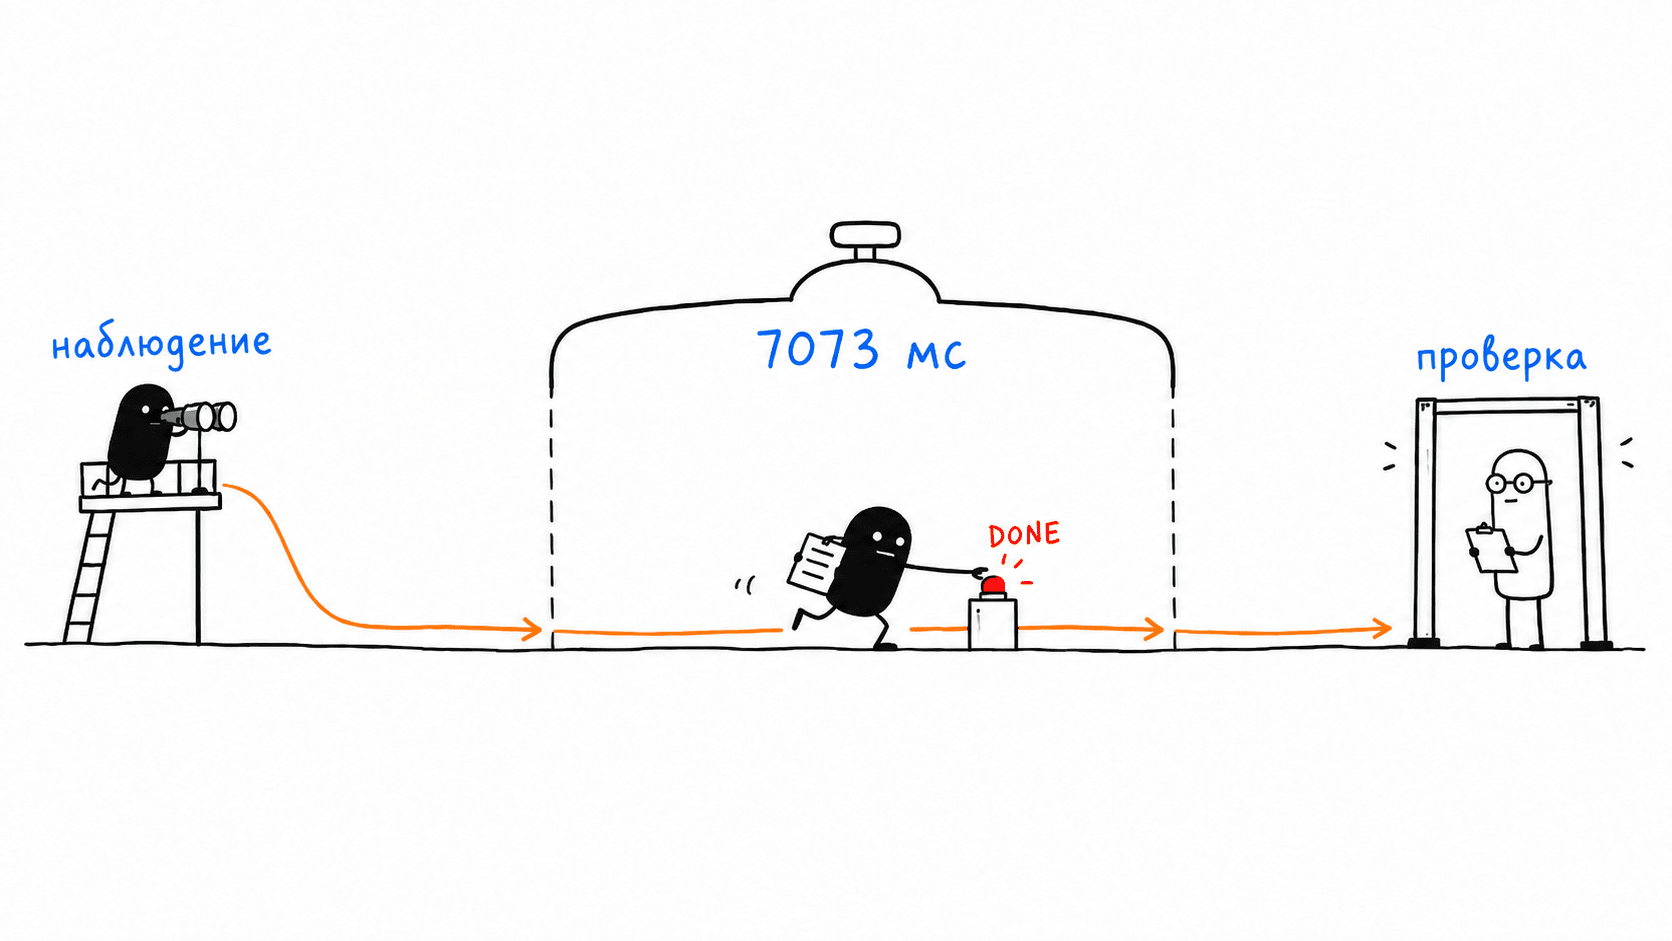
Опубликованный Flights trace занял 7073 мс. За это время агент сделал 17 запросов Jev, 11 браузерных действий и два вызова Mercury. Он нашёл результаты Google Flights по маршруту Zurich → London на заданную дату. Билет не бронировал.
Jev занял 3720 мс, или 52,59% всего измеренного времени. Два текстовых вызова добавили 927 мс. Вызовы обеих моделей заняли 4647 мс, то есть 65,70% полного времени. Остальное время ушло на снимки страницы, исполнение и работу браузерной среды.
Эти 7073 мс охватывают только цикл агента. Таймер запускается после начального наблюдения, перед первым обращением к модели, и останавливается на принятом DONE. Настройка браузера, первоначальная навигация и финальный verifier в семь секунд не входят. Причём DONE выбирает та же policy-модель. Успех доказывает отдельная проверка маршрута, даты и видимых результатов уже за границей таймера.
В произвольной задаче такого verifier нет, пока его не написал разработчик. Агент, который сам объявил работу законченной, напоминает студента, проверившего собственный экзамен. Иногда всё действительно правильно, но контроль от этого независимым не становится.
Стоимость вызовов моделей здесь можно посчитать довольно точно. 90 558 входных токенов Jev по текущей цене стоят $0.003803436. Mercury добавил $0.00006272. Всего $0.003866156, без стоимости браузерной инфраструктуры. Около 98,38% расходов на модели пришлось на Jev: повторная отправка состояния оказалась дороже двух коротких генераций текста.
Авторы сравнили старую и новую версии среды исполнения на трёх чередующихся парах той же задачи. Медиана упала с 9,450 до 7,092 секунды, примерно на 25%, а число CDP-вызовов с 1092 до 101. Все шесть прогонов прошли verifier, но sign-test даёт p = 0,25. Это ускорение среды на одной задаче, не сравнительный тест Jev против LLM, локального классификатора или Playwright.
Сторонний тест Retriever добавляет полезный контрпример. В двух сценариях конфигурация с Jev была на 31% и 43% быстрее, но на 38% и 51% дороже. Из 50 обращений 39 были Score: предварительная фильтрация съела экономию дешёвого решения. На каждую конфигурацию был один прогон, сырых трасс нет, поэтому проценты обобщать нельзя. В этих двух сценариях быстрая модель не сделала систему дешёвой.
15 проектов на Jev: от авиабилетов до StarCraft
В итоговую пятнашку вошли проекты, которые лучше всего показывают диапазон Jev. Это не рейтинг: рядом стоят выпущенный код, единичные демо и авторские заявления. Репозиторий подтверждает, что проект существует, но ещё ничего не говорит о точности и надёжности в production.
Выбирать следующее действие
jev-ultrafastпоказывает динамическийaction space: Jev выбирает операцию и цель, браузерная обвязка исполняет действие, а Mercury пишет текст для полей. Архитектуру и границы семисекундного прогона мы разобрали выше.mobile-jevперенёс тот же принцип на Android. Jev получает доступные элементы интерфейса и выбирает следующийtap; в демонстрации агент заказал Uber за девять действий примерно за 21 секунду. Код открыт, однако других сценариев для оценки надёжности пока нет.- Justin Schroeder заявил, что меньше чем за час пересобрал Tesla Full Self-Driving на Jev. Опубликованный следом
JevPilotоказался играбельным симулятором на Three.js: модель выбирает траекторию и скорость, а геометрия, поиск маршрута и аварийное торможение остаются в обычном коде. - Одной пройденной миссии недостаточно для систематической оценки. Но оригинальный StarCraft хорошо подходит под контракт Jev: в игре конечный набор команд, модель управляет клавиатурой и мышью и сохраняет вероятности выбранных действий. Astra прошла миссию с первой попытки. До Androide и его серебра на WCG 2005 ей, конечно, далеко.
Проверять агента перед действием
pi-wardenстоит между агентом и его инструментами. Перед выполнением команды Jev оценивает необратимость, соответствие плану, внешние последствия, повторяющиеся циклы и подозрительно раннееdone. Автор прогнал проверку на 17 тысячах собственных вызовов инструментов, но исходные сессии и полный результат не опубликовал.- Плагин разрешений для OpenCode проверяет намерение агента, прежде чем разрешить ему обратиться к домену. Автор пишет, что Jev поймал все показанные попытки обойти запрет. Публичного набора атак нет, поэтому это пока удачное демо защитного шлюза, а не доказанная граница безопасности.
- Discord-бот оценивает сообщения на спам, фишинг и социальную инженерию. Код превращает вероятности Jev в четыре уровня реакции: от пропуска до жёсткой эскалации. Метрик точности авторы не дали. Зато разделение ролей видно в коде: модель выставляет оценку, а последствия задаёт программа.
Помогать другим моделям
fast-jev-compactionранжирует старые вызовы инструментов Claude Code и дословно сохраняет те, которые считает полезными. В демонстрации объём контекста сократился с миллиона до 86 тысяч токенов примерно за секунду. Репозиторий подтверждает механику отбора, но не доказывает, что среди отброшенных 914 тысяч токенов не потерялось важное.jev-routerвыбирает модель для запросов Claude Code и Codex: простые задачи можно отправить дешёвой модели, сложные — более сильной. Экономия появляется только при достаточно точной маршрутизации. Иначе дешёвое первое решение оборачивается дорогим исправлением.
Разбирать большие потоки данных
pg-jevдобавляет в PostgreSQL функцию для условий на естественном языке. Получается своеобразный нечёткийWHERE: строки можно фильтровать по смыслу без заранее подготовленных эмбеддингов. Цена, точность и скорость полного прохода по большой таблице пока не измерены.unclutterпревращает Jev в семантический фильтр для веб-страниц. Пользователь задаёт правило обычной фразой, расширение классифицирует элементы страницы и запоминает шаблоны удаления. Так модель вызывается не при каждом открытии сайта, хотя качество самих правил независимо никто не проверял.- Другое расширение слушает аудио YouTube и пропускает рекламные интеграции внутри ролика. Автор оценил стоимость примерно в
$0.005на видео. Насколько точно оно ловит начало и конец рекламы и сколько обычной речи съедает заодно, из публикации неизвестно. Но лучше поставить SponsorBlock. - В эксперименте с 1018 AI-статьями Jev распределил материалы по 24 темам. Автор заявил
$0.08за весь набор и медиану 256 мс на статью. Правда, Jev видел уже готовые резюме от DeepSeek, поэтому эти цифры описывают только второй этап цепочки.
Проверять крайние идеи
jev-traderвыбираетbuy,sellили ожидание для пары MON-USDC на каждом 300-миллисекундном блоке Monad. Демо. В коде есть режим реальных ордеров, но по умолчанию бот работает вmock/dry-run. Публичной транзакции или истории доходности автор не показал. Ну что, додеп?killmyideaзадаёт около десяти вопросов о стартапе параллельно и собирает из ответов численную оценку. Свободный текст модели здесь вообще не нужен: Jev выставляет баллы, а интерфейс превращает их в разбор. Такой цифровой волк с Уолл-стрит полезен ровно настолько, насколько хороши его критерии.
Два теста, где скорость не спасла
На 1565 немецких и английских деловых письмах Gemini оказался точнее Jev при классификации по десяти категориям. Автор всё равно рассматривал Jev для production из-за других преимуществ, но универсальной победы по качеству не получилось.
В открытом тесте на 2000 фишинговых письмах Jev проиграл Claude Haiku 4.5 по точности. Код опубликован, сам результат независимо ещё не воспроизводили. Два разных датасета не складываются в общий рейтинг, но хорошо отрезвляют после роликов с автомобилями, играми и торговыми ботами.
Стоит ли брать Jev прямо сейчас
Тестировать Jev стоит, если ваша LLM уже выбирает метку, маршрут или действие из конечного списка, а вы хотите сократить задержку и стоимость. Если такой задачи у вас пока нет, сам по себе хайп вокруг Jev её не создаёт.
Есть смысл попробовать, если
- LLM возвращает категорию, оценку или
yes/no, а сгенерированное объяснение вы всё равно выбрасываете. - Несколько последовательных решений тормозят систему, и их можно объединить через
speculative fan-out. - У вас уже есть список разрешённых действий, проверка результата и резервный сценарий. Jev только выбирает, код по-прежнему исполняет.
Лучшие первые кандидаты уже встретились выше: маршрутизация моделей и инструментов, защитная проверка перед внешним действием, массовая классификация и ранжирование. Во всех трёх случаях правильный ответ можно перечислить заранее, а ошибку — заметить до того, как она станет дорогой.
Пока не стоит, если
- результатом должен быть новый текст, код или план;
- задачу надёжно решает обычный код или Playwright;
- у вас стабильный узкий домен и достаточно размеченных данных для локального классификатора;
- состояние нельзя отправлять в закрытое облако;
- ошибку невозможно дёшево проверить;
- решение сразу запускает необратимое действие.
Страница ограничений Jev 1.13 добавляет к этому списку арифметику, даты, косвенные вопросы, большой объём нерелевантного контекста, противоречивые критерии и adversarial content. Эти части TypeSafe советует оставлять обычному коду.
Что должен доказать пилот
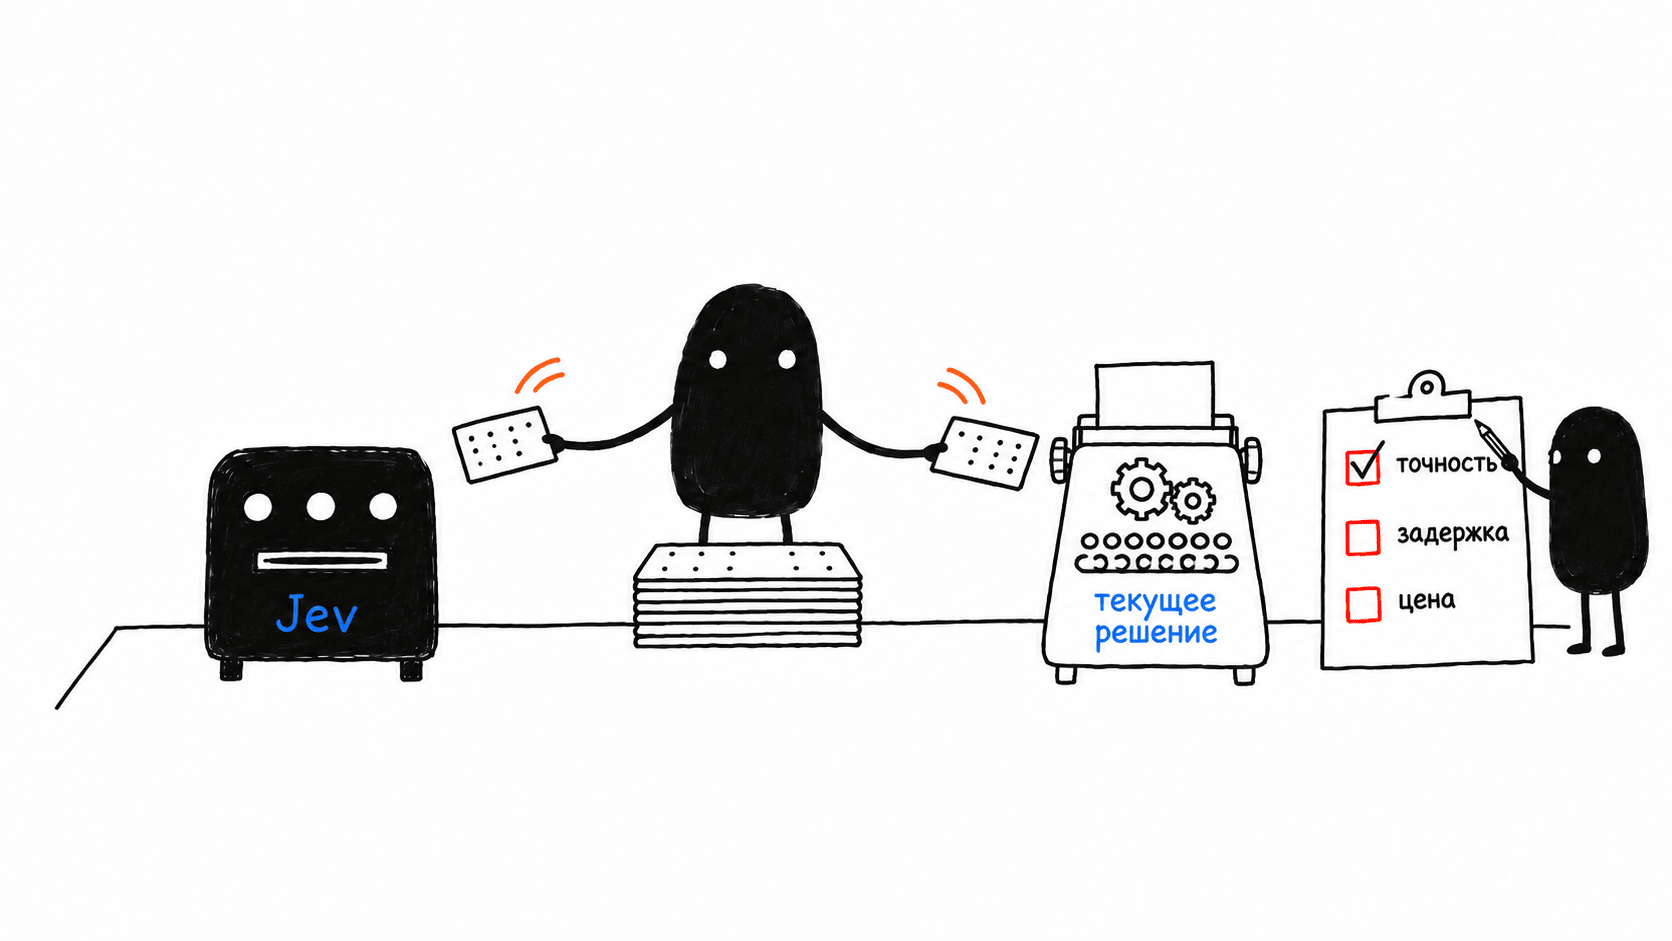
Прогоните Jev и текущее решение на одной размеченной выборке. Сравните точность, задержку и полную стоимость цепочки, затем подберите порог confidence и резервный маршрут. Если сравнивать не с чем, получится ещё одно красивое демо, а не основание менять систему.
Если сама идея типизированного выбора подходит, но закрытое облако — нет, jevlike и openjev позволяют проверить похожий интерфейс на локальных моделях. Они не воспроизводят закрытый Jev, его качество или RLCD. У одного из заявленных Qwen-RLCD артефактов даже нет собственных загруженных весов.
Первая волна нашла для Jev много мест, но пока не доказала, что одна модель одинаково хороша во всех них. Для технологии, которой три дня, это нормальный итог.
Jev предлагает контракт, в котором приложение заранее описывает мир допустимых ответов, модель распределяет между ними вероятность, а код сохраняет власть над действием и проверкой. Это ограничение становится преимуществом только тогда, когда разработчик правильно описал такой мир.
Если нужной кнопки нет среди 250 элементов, правильного класса нет в Choice, а опасное действие некому проверить, Jev всё равно вернёт идеально валидный ответ. Просто не тот, который вам нужен.
Оставайтесь любопытными.
Пишу об искусственном интеллекте, языковых моделях и инструментах для разработчиков. Тестирую модели и сервисы на реальных задачах, а выводами делюсь в телеграм-канале.
Частые вопросы о Jev
Что такое Jev?
Jev — закрытая модель решений от TypeSafe. Приложение передаёт ей состояние и заранее описывает допустимые ответы через Noul, Choice или Score. В ответ API возвращает выбранные значения и распределения вероятностей, а не свободный текст. Такой контракт гарантирует форму результата, но не его фактическую правильность.
Чем Jev отличается от обычной LLM?
Обычная LLM авторегрессионно продолжает последовательность токенов и может сгенерировать текст, код или JSON. Jev работает внутри заданного приложением пространства вариантов и выбирает между ними. Это убирает синтаксически недопустимые ответы, но Jev всё ещё может уверенно выбрать неверный вариант из разрешённого списка.
Гарантирует ли Jev отсутствие галлюцинаций?
Только в узком смысле. Если приложение разрешило три класса, Jev не вернёт четвёртый класс или свободное объяснение. Но модель может выбрать неправильный разрешённый класс. Значение confidence также не равно вероятности правильного ответа: пороги нужно калибровать на собственных размеченных данных с учётом цены ошибки.
Как получить доступ к Jev API?
Прямой API TypeSafe на момент проверки 18 сентября 2026 года оставался в early access и использовал POST /v1/systemone. Jev также был доступен через Vercel AI Gateway, OpenRouter и Cloudflare Workers AI. У каждого маршрута свои ключи, биллинг, endpoint и ограничения, поэтому считать их взаимозаменяемыми прокси нельзя.
Сколько стоит Jev?
На 18 сентября 2026 года документация TypeSafe указывала цену $0.042 за миллион входных токенов без платы за выходные токены. Полная стоимость системы зависит от числа вызовов и повторной отправки состояния. В опубликованном Flights trace 90 558 входных токенов Jev стоили около $0.0038 без браузерной инфраструктуры.
Для каких задач подходит Jev?
Jev стоит тестировать там, где результат можно заранее перечислить: для классификации, маршрутизации, ранжирования, защитной проверки и выбора следующего действия агента. Хороший пилот требует размеченной выборки, дешёвой независимой проверки и резервного сценария. Для генерации текста, детерминированных правил или необратимых действий без проверки лучше выбрать другой инструмент.